Tag: نوآوری فناوری

  • یک چهارم مقالات ریاضی هوش مصنوعی را تایید می‌کنند

    یک چهارم مقالات ریاضی هوش مصنوعی را تایید می‌کنند

    انقلاب خاموش در ریاضیات: هوش مصنوعی، سرعت تحول را شتاب می‌بخشد

    در ماه مارس، کمتر از ۵ درصد از مقالات ریاضی منتشر شده در آرشیو arXiv به استفاده از هوش مصنوعی اشاره داشتند. اما تا ۲۰ اوت، این رقم از ۲۴ درصد عبور کرد. این یک روند صعودی ملایم نیست؛ بلکه خطی عمودی بر نموداری است که هر استارتاپ در مرحله رشد را به حسادت وامی‌دارد.

    این داده‌ها از یک پیش‌چاپ با عنوان «تب طلا در AI4Math: اکنون در کجا هستیم؟» (The Gold Rush in AI4Math: Where Are We Now?) که توسط جی‌اشون جین، ژنگ تریسی کی و بینگ‌چنگ سوی تهیه شده، به دست آمده است. این مطالعه ۳۲,۹۴۴ مقاله ریاضی ارسال شده به arXiv را بین ۱ مارس و ۲۰ اوت ۲۰۲۶ تحلیل کرده است. یافته‌ها تصویری از رشته‌ای در میانه تحولی سریع و عمدتاً داوطلبانه را ترسیم می‌کنند.

    آمار کلیدی، یعنی ۲۴.۱۴ درصد از پیش‌چاپ‌های ریاضی که تا ماه اوت به هوش مصنوعی اذعان کرده‌اند، به خودی خود چشمگیر است. اما معیار قابل‌توجه‌تر، آنچه محققان «مشارکت‌های ماهوی هوش مصنوعی» می‌نامند، است؛ یعنی مواردی که هوش مصنوعی نه تنها در غلط‌گیری یا قالب‌بندی نقش داشته، بلکه واقعاً در کار ریاضی مشارکت کرده است.

    این رقم از ۱.۳۹ درصد در ماه مارس به ۱۴.۰۹ درصد تا ۲۰ اوت جهش یافته است. به عبارت دیگر، تقریباً از هر هفت مقاله ریاضی، یکی اکنون هوش مصنوعی را در حال انجام کارهای فکری سنگین واقعی به نمایش می‌گذارد.

    از میان ۳۲,۹۴۴ مقاله تحلیل شده، ۳,۵۷۵ مورد شکلی از استفاده از هوش مصنوعی را تأیید کرده‌اند. از این تعداد، ۱,۷۱۲ مورد شامل آنچه محققان مشارکت‌های ماهوی طبقه‌بندی کرده‌اند، بوده است. بخش عمده‌ای از این کارهای ماهوی بر ساخت اثبات متمرکز بوده است.

    این مطالعه همچنین ابزارهای هوش مصنوعی را که محققان به کار می‌برند، ردیابی کرده است. محصولات OpenAI در بیش از ۶۰ درصد مقالات با استفاده تأیید شده از هوش مصنوعی ظاهر شده‌اند. ابزارهای Anthropic در جایگاه دوم قرار گرفتند.

    پذیرش هوش مصنوعی به طور یکنواخت در سراسر این رشته در حال گسترش نیست. ترکیبیات (Combinatorics) از نظر حجم محض استفاده ماهوی از هوش مصنوعی پیشتاز است. در همین حال، هندسه متریک (Metric Geometry) بالاترین نرخ پذیرش هوش مصنوعی را نسبت به اندازه خود ثبت کرده است.

    از نظر جغرافیایی، ایالات متحده و چین سلطه دارند. این دو کشور با هم تقریباً دو سوم وزن تعداد نویسندگان در مقالات ریاضی با کمک هوش مصنوعی را به خود اختصاص می‌دهند.

    شاید تحریک‌آمیزترین یافته این مطالعه مربوط به مسائل باز (open problems) باشد. محققان ۷۱۷ رکورد مسئله باز را که با مقالاتی با مشارکت‌های ماهوی هوش مصنوعی مرتبط بودند، شناسایی کردند. از این تعداد، ۷۱ درصد توسط نویسندگانشان به عنوان کاملاً حل شده گزارش شده‌اند.

    پیش‌چاپ‌ها در arXiv داوری همتا (peer-reviewed) نمی‌شوند و تاریخ ریاضیات مملو از اثبات‌های ادعا شده‌ای است که در برابر بررسی مقاومت نکرده‌اند. اما حتی با در نظر گرفتن درصدی از پیروزی‌های زودهنگام، حجم راه‌حل‌های ادعا شده نشان می‌دهد که هوش مصنوعی ریاضیدانان را قادر می‌سازد تا مسائلی را که در غیر این صورت ممکن بود به آن‌ها نپردازند، حل کنند.

    حالت غالب مشارکت، ساخت اثبات است. هوش مصنوعی شهود ریاضیدان در مورد اهمیت مسائل یا استراتژی‌های احتمالی را جایگزین نمی‌کند. بلکه بیشتر شبیه یک همکار فوق‌العاده سریع و خستگی‌ناپذیر عمل می‌کند که می‌تواند مسیرهای اثبات را کاوش کرده و مراحل منطقی را در مقیاسی که هیچ انسانی قادر به تطبیق آن نیست، تأیید کند.

    نویسندگان این مطالعه طرفدار افشای شفاف استفاده از هوش مصنوعی هستند، که قابل توجه است زیرا رقم فعلی ۲۴ درصد تنها مقالاتی را شامل می‌شود که داوطلبانه به آن اذعان کرده‌اند. تعداد واقعی مقالات با کمک هوش مصنوعی تقریباً به طور قطع بالاتر است.

    با تسلط ابزارهای OpenAI بر بیش از ۶۰ درصد مقالات تأیید شده با کمک هوش مصنوعی، انتخاب پلتفرم هوش مصنوعی به یک تصمیم استراتژیک برای محققان تبدیل می‌شود. Anthropic در جایگاه دوم قرار دارد، اما شکاف قابل توجه به نظر می‌رسد. برای شرکت‌های هوش مصنوعی، تبدیل شدن به ابزار پیش‌فرض برای تحقیقات ریاضی صرفاً یک بازی اعتبار نیست؛ بلکه یک حلقه بازخورد است: هرچه محققان بیشتر از سیستم شما استفاده کنند، سیگنال آموزشی بیشتری در مورد وظایف استدلال دشوار دریافت می‌کنید، که سیستم شما را در انجام وظایف استدلال دشوار بهتر می‌کند.

    تمرکز خروجی در ایالات متحده و چین نیز پیامدهایی برای تحقیقات ریاضی جهانی دارد. کشورها و مؤسساتی که به مدل‌های پیشرفته هوش مصنوعی دسترسی ندارند، در معرض عقب افتادن هستند، نه به دلیل اینکه ریاضیدانانشان کمتر با استعداد هستند، بلکه به این دلیل که بدون ابزارهای مشابه کار می‌کنند.

  • سیرکل ونیز را به بازارچه عامل خود برای خدمات هوش مصنوعی اضافه کرد

    سیرکل ونیز را به بازارچه عامل خود برای خدمات هوش مصنوعی اضافه کرد

    بازارچه عامل Circle میزبان استارتاپ هوش مصنوعی Venice.

    ai شد

    شرکت Circle با افزودن Venice.ai، استارتاپ نوآورانه هوش مصنوعی با تمرکز بر حریم خصوصی که توسط اریک وورهیس تأسیس شده است، به بازارچه عامل خود، گامی مهم در توسعه اکوسیستم عامل‌های هوش مصنوعی برداشته است. این پلتفرم اکنون به عنوان ارائه‌دهنده خدمات در مرکز رو به رشد Circle برای تراکنش‌های عامل هوش مصنوعی فهرست شده است.

    دسترسی بی‌درنگ به خدمات هوش مصنوعی با USDC

    این ادغام به عامل‌های هوش مصنوعی امکان می‌دهد تا به خدمات خلاقانه و استنتاجی Venice.ai، از جمله تولید تصویر، ساخت ویدئو و دسترسی به کتابخانه‌ای شامل بیش از ۲۰۰ مدل هوش مصنوعی، دسترسی پیدا کنند. نکته قابل توجه این است که تمامی این خدمات با استفاده از USDC قابل پرداخت هستند و نیازی به کلیدهای API، اشتراک یا حتی حساب کاربری نیست.

    زیرساخت نوآورانه Circle برای عامل‌های هوش مصنوعی

    Circle در تاریخ ۱۱ مه ۲۰۲۶، پلتفرم Agent Stack خود را راه‌اندازی کرد. این زیرساخت به طور خاص برای عامل‌های هوش مصنوعی طراحی شده است تا بتوانند خدمات مورد نیاز خود را به طور مستقل کشف، دسترسی و هزینه آن‌ها را پرداخت کنند. بازارچه عامل (Agent Marketplace) قلب این پلتفرم است؛ یک دایرکتوری ساختاریافته که در آن خدمات پیش از ارائه، بررسی و از نظر انطباق ارزیابی می‌شوند و از طریق یک API کشف کلید-محور در دسترس قرار می‌گیرند.

    رشد چشمگیر بازارچه عامل Circle

    این بازارچه در مدت کوتاهی پس از راه‌اندازی، از بیش از ۶۰۰ سرویس فعال به بیش از ۹۰۰ سرویس رسیده است که نشان‌دهنده رشدی حدوداً ۵۰ درصدی در خدمات موجود در بیش از ۱۵ بلاکچین مختلف است.

    پروتکل x402 و پرداخت‌های نانو بدون کارمزد

    پرداخت‌ها از طریق پروتکل x402 انجام می‌شود که احراز هویت کیف پول برای تراکنش‌های USDC را در شبکه‌هایی مانند Base و Solana مدیریت می‌کند. نوآوری کلیدی در این زمینه، امکان پرداخت‌های نانو بدون کارمزد (gasless nanopayments) در مقیاس‌های زیر یک سنت است.

    Venice.

    ai: حریم خصوصی در قلب نوآوری

    Venice.ai با قرار دادن حریم خصوصی به عنوان نقطه قوت اصلی خود، جایگاه ویژه‌ای در فضای هوش مصنوعی ایجاد کرده است. تمامی تعاملات با مدل‌های این پلتفرم به صورت رمزنگاری شده در سمت کلاینت انجام می‌شود و Venice.ai هیچ‌گونه داده کاربری را ذخیره نمی‌کند. این شرکت دسترسی به بیش از ۲۰۰ مدل هوش مصنوعی را فراهم می‌کند که طیف وسیعی از تولید متن تا تولید رسانه‌های خلاقانه را پوشش می‌دهد. Venice.ai روزانه بیش از ۱ میلیون درخواست API را پردازش می‌کند که نشان‌دهنده مقیاس فعالیت آن حتی پیش از ادغام با Circle است.

    موفقیت مالی و جایگاه یونیکورن

    اریک وورهیس در ژوئیه ۲۰۲۶ موفق به جذب ۶۵ میلیون دلار سرمایه در دور سری A برای Venice.ai شد. این دور سرمایه‌گذاری، ارزش شرکت را به ۱ میلیارد دلار رساند و کمتر از دو سال پس از تأسیس در سال ۲۰۲۴، به آن جایگاه یونیکورن (شرکت با ارزش بیش از ۱ میلیارد دلار) را بخشید.

    ادغام فنی و مزایای استراتژیک

    Venice.ai پیش از پیوستن به بازارچه Circle، احراز هویت کیف پول x402 را برای پرداخت‌های USDC در شبکه‌های Base و Solana پیاده‌سازی کرده بود، بنابراین زیرساخت فنی لازم تا حد زیادی آماده بود. فهرست شدن در Circle به طور موثر Venice.ai را در معرض دید تمامی عامل‌های هوش مصنوعی که در حال حاضر از این بازارچه برای یافتن خدمات استفاده می‌کنند، قرار می‌دهد.

    حذف موانع پرداخت برای عامل‌های هوش مصنوعی

    در حال حاضر، اکثر خدمات هوش مصنوعی نیازمند ایجاد حساب کاربری، مدیریت کلیدهای API و سروکار داشتن با سیستم‌های صورتحساب طراحی شده برای کاربران انسانی هستند. عامل‌های هوش مصنوعی که به طور مستقل عمل می‌کنند، قادر به پیمایش در صفحات پرداخت مانند Stripe نیستند. بازارچه Circle این لایه پیچیده را حذف کرده و آن را با پرداخت‌های برنامه‌نویسی شده USDC که فوراً تسویه می‌شوند، جایگزین می‌کند.

    فرصت‌های جدید برای USDC

    از منظر پرداخت، USDC با یک دسته جدید از حجم تراکنش‌ها روبرو می‌شود که تا یک سال پیش تقریباً وجود نداشت. هر فراخوانی API که از طریق این بازارچه پردازش می‌شود، یک تراکنش USDC محسوب می‌شود. با ضرب این عدد در بیش از یک میلیون فراخوانی روزانه که Venice.ai در حال حاضر مدیریت می‌کند، پتانسیل توان عملیاتی قابل توجهی ایجاد می‌شود.

    دسترسی به نسل جدید مشتریان

    برای Venice.ai به طور خاص، این ادغام دسترسی به یک دسته کاملاً جدید از مشتریان را باز می‌کند: عامل‌های خودکار که خدمات را بدون دخالت انسان کشف و خریداری می‌کنند.

  • رئیس انویدیا: پیش‌بینی هزینه ۴ تریلیون دلاری هوش مصنوعی تا ۲۰۳۰

    رئیس انویدیا: پیش‌بینی هزینه ۴ تریلیون دلاری هوش مصنوعی تا ۲۰۳۰

    جنسن هوانگ، مدیرعامل انویدیا، پیش‌بینی خود مبنی بر رسیدن هزینه‌های جهانی زیرساخت هوش مصنوعی به رقمی بین ۳ تا ۴ تریلیون دلار در سال تا پایان دهه جاری را مجدداً تأیید کرد. او این اظهارات را در کنفرانس فناوری و ارتباطات گلدمن ساکس در ۱۰ سپتامبر ۲۰۲۶ بیان کرد، در حالی که دقیقاً همین پیش‌بینی را یک سال قبل در همین کنفرانس مطرح کرده بود.

    درآمد بی‌سابقه انویدیا

    انویدیا درآمدی معادل ۹۶.۲ میلیارد دلار را برای فصل دوم سال مالی ۲۰۲۷ گزارش کرده است که نشان‌دهنده رشد ۱۰۶ درصدی نسبت به سال گذشته است. از این میزان، ۸۹ میلیارد دلار تنها از عملیات مراکز داده حاصل شده است.

    پایان قانون مور و نیاز به سخت‌افزار تخصصی

    هوانگ بخشی از این شتاب را به “مرگ قانون مور” نسبت داد. بهبودهای سنتی در تراشه‌ها، که شامل دو برابر شدن چگالی ترانزیستورها در هر دو سال می‌شد، عملاً متوقف شده است. این امر شرکت‌هایی را که به دنبال دستیابی به عملکرد بالا در هوش مصنوعی هستند، وادار می‌کند تا به جای انتظار برای نسل بعدی سیلیکون، سخت‌افزارهای تخصصی‌تری خریداری کنند.

    محدودیت‌های عرضه و گلوگاه حافظه

    با این حال، عرضه قادر به همگام شدن با تقاضا نیست. هوانگ در دسترس بودن تراشه‌های حافظه را به عنوان گلوگاه اصلی معرفی کرد که در حال حاضر توانایی انویدیا را برای عرضه محصولات بیشتر محدود می‌کند.

    قیمت‌گذاری محصولات جدید

    در بخش قیمت‌گذاری محصولات، اعداد گویای همه چیز هستند. پردازنده‌های گرافیکی نسل Hopper انویدیا حدود ۱۸ هزار دلار در هر واحد قیمت دارند. معماری جدیدتر Blackwell حدود ۲۵ هزار دلار برای هر تراشه هزینه دارد و پلتفرم آتی Vera Rubin با قیمتی تقریبی ۴۰ هزار دلار عرضه خواهد شد.

    افزایش هزینه‌های سرمایه‌ای ابرمقیاس‌دهنده‌ها

    ابر‌مقیاس‌دهنده‌ها (Hyperscalers) انتظار دارند هزینه‌های سرمایه‌ای ترکیبی خود را از حدود ۸۰۰ میلیارد دلار در سال ۲۰۲۶ به تقریباً ۱.۳ تریلیون دلار در سال ۲۰۲۷ افزایش دهند که این نشان‌دهنده جهش سالانه حدود ۶۰ درصدی است.

    سرمایه‌گذاری ۵۰۰ میلیارد دلاری در مراکز داده هوش مصنوعی

    انویدیا همچنین با شرکت‌های بزرگ مالی برای هدایت بیش از ۵۰۰ میلیارد دلار به پروژه‌های مراکز داده هوش مصنوعی همکاری کرده است.

    پیش‌بینی رشد درآمد انویدیا

    برای سال مالی ۲۰۲۸، انویدیا رشد درآمدی حدود ۷۰ درصد را پیش‌بینی می‌کند، در حالی که اجماع جامعه تحلیلگران رقمی نزدیک به ۴۵ درصد را نشان می‌دهد.

    فرصت‌های سرمایه‌گذاری در زنجیره تأمین نیمه‌هادی‌ها

    محدودیت‌های زنجیره تأمین که هوانگ به آن‌ها اشاره کرده است، یک فرضیه سرمایه‌گذاری ثانویه را در بخش نیمه‌هادی‌ها ایجاد می‌کند. شرکت‌هایی که حافظه‌های با پهنای باند بالا و بسته‌بندی پیشرفته تولید می‌کنند، از این وضعیت سود خواهند برد زیرا گلوگاه‌ها سرمایه را جذب می‌کنند. این کمبود همچنین فرصتی را برای معماری‌های تراشه رقیب فراهم می‌کند تا با ابر‌مقیاس‌دهنده‌هایی که به دنبال تنوع بخشیدن به تأمین‌کنندگان سخت‌افزار خود و کاهش وابستگی به یک فروشنده واحد هستند، جایگاه خود را پیدا کنند.

  • حمایت نهادهای اتریوم از پیشنهاد Ethlabs برای کاهش زمان بلاک

    حمایت نهادهای اتریوم از پیشنهاد Ethlabs برای کاهش زمان بلاک

    حمایت سازمان Ethereum Institutional از طرح افزایش سرعت شبکه اتریوم

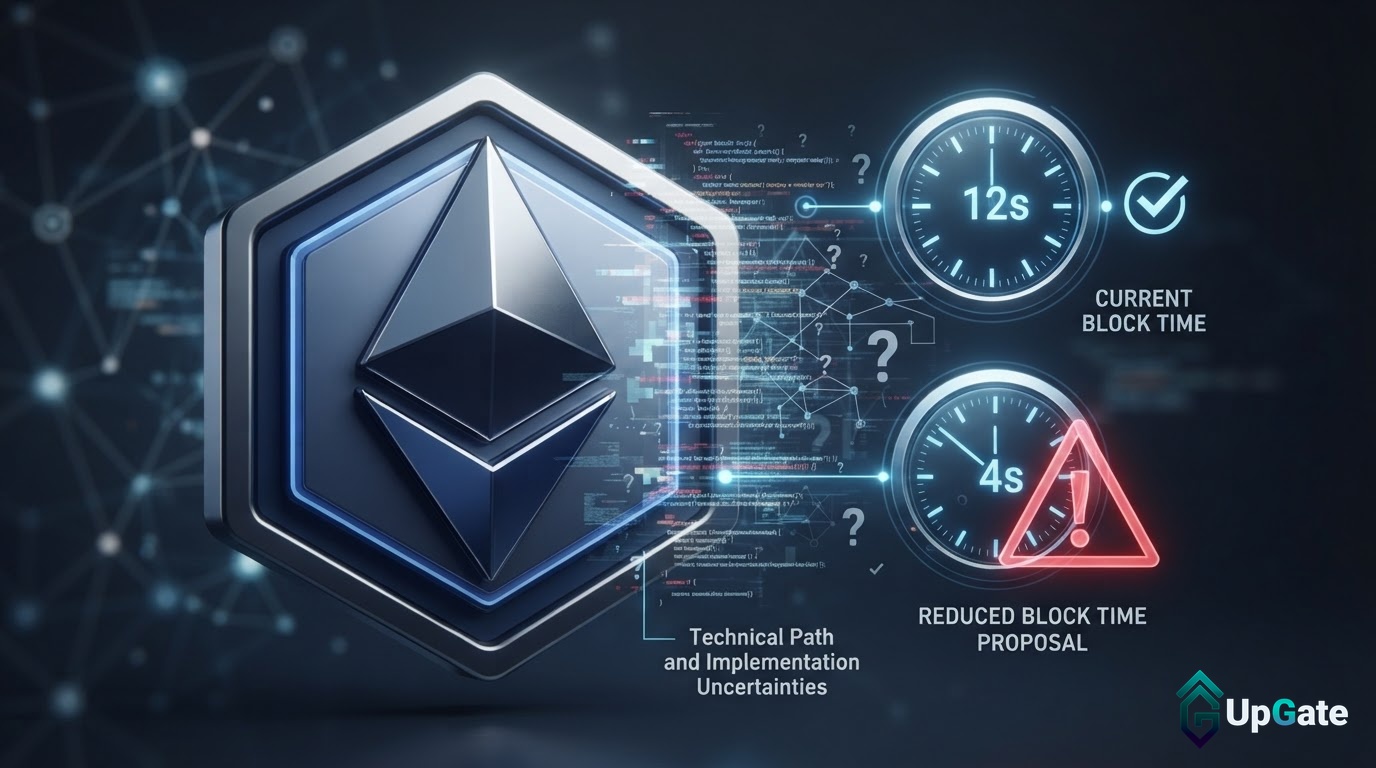
    سازمان غیرانتفاعی Ethereum Institutional، که توسط اعضای سابق بنیاد اتریوم تأسیس شده است، از پیشنهادی برای افزایش قابل توجه سرعت شبکه اتریوم حمایت کرده است. این سازمان از EIP-8198، طرحی از آزمایشگاه تحقیقاتی Ethlabs برای کاهش زمان بلاک اتریوم از ۱۲ ثانیه به ۱۰ ثانیه، به عنوان بخشی از ارتقاء Hegotá که در حال حاضر برای سال ۲۰۲۷ برنامه‌ریزی شده است، پشتیبانی می‌کند.

    طرح “اسلات‌های سریع”

    این پیشنهاد که با نام مستعار “اسلات‌های سریع” (Quick Slots) شناخته می‌شود، زمان اسلات اتریوم را هدف قرار می‌دهد؛ بازه زمانی ثابتی که اعتبارسنج‌ها بلاک‌های جدید را پیشنهاد می‌کنند. در حال حاضر این بازه ۱۲ ثانیه است. EIP-8198 آن را به ۱۰ ثانیه کاهش می‌دهد که بخشی از ارتقاء Hegotá خواهد بود.

    رویکرد پارامتریک برای زمان‌بندی

    این طرح نیازمند یک بازسازی یک‌باره کلاینت است که زمان‌بندی اسلات را پارامتریک می‌کند. به جای کدنویسی ثابت بازه بلاک، توسعه‌دهندگان یک تنظیم‌کننده ایجاد خواهند کرد که بتواند در آینده مجدداً تغییر کند. کاهش اولیه به ۱۰ ثانیه به عنوان یک گام اولیه طراحی شده است، نه یک مقصد نهایی.

    تأثیر بر نهایی‌سازی و اعتماد نهادی

    نهایی‌سازی فعلی اتریوم معمولاً حدود ۱۵ دقیقه در دو دوره زمانی طول می‌کشد. اگرچه EIP-8198 مستقیماً نهایی‌سازی را بازنگری نمی‌کند، اما تولید سریع‌تر بلاک، کل فرآیند را فشرده‌تر می‌کند. متیو داوسون، یکی از بنیان‌گذاران Ethereum Institutional، این حمایت را از منظر مالی بیان کرد و استدلال نمود که بهبود سرعت بلاک مستقیماً جذابیت اتریوم را برای بازیگران نهادی افزایش می‌دهد و اعتماد به قابلیت استفاده این پلتفرم را به عنوان زیرساخت مالی اصلی تقویت می‌کند.

    آزمایشگاه Ethlabs و حمایت اکوسیستم

    Ethlabs در ۲۲ ژوئن ۲۰۲۶ به عنوان یک آزمایشگاه تحقیقات و توسعه غیرانتفاعی با حمایت جو لوبین، یکی از بنیان‌گذاران اتریوم، راه‌اندازی شد و توسط محققان سابق بنیاد اتریوم از جمله کارل بیک‌هویزن و بارنابِه مونوت اداره می‌شود. بازخورد جمع‌آوری شده از حدود ۲۰ شرکت‌کننده در اکوسیستم، از جمله پروتکل‌های بزرگی مانند Lido و Ondo، نشان‌دهنده حمایت گسترده از این طرح است. هیچ نگرانی قابل توجهی در مورد تمرکززدایی یا مشارکت اعتبارسنج‌ها مطرح نشده است.

    مزایای تجاری و مقاومت در برابر سانسور

    هنگامی که تأیید یک معامله در صرافی غیرمتمرکز (DEX) ۱۲ ثانیه طول می‌کشد، بازارسازان برای جبران ریسک نوسانات قیمت در این بازه، اسپرد (اختلاف قیمت خرید و فروش) وسیع‌تری را متحمل می‌شوند. کاهش زمان بلاک به ۱۰ ثانیه این پنجره ریسک را تقریباً ۱۷ درصد کاهش می‌دهد که مستقیماً به اسپرد تنگ‌تر و اجرای بهتر برای معامله‌گران منجر می‌شود. حامیان EIP-8198 همچنین به مزایای مقاومت در برابر سانسور اشاره می‌کنند، به ویژه هنگامی که با FOCIL (لیست‌های گنجاندن اجباری) ترکیب شود؛ مکانیزم پیشنهادی دیگری که برای جلوگیری از حذف انتخابی تراکنش‌ها توسط اعتبارسنج‌ها طراحی شده است.

    چارچوبی برای کاهش‌های آینده

    جنبه پارامتریک EIP-8198 به این معنی است که جامعه اتریوم می‌تواند از طریق پیشنهادات حاکمیتی، به جای ارتقاء کامل پروتکل، به کاهش زمان اسلات ادامه دهد و چارچوبی برای کاهش‌های آتی زمان بلاک بدون نیاز به هارد فورک مجدد برای هر تغییر تدریجی ایجاد کند. تقریباً ۲۰ شرکت‌کننده اصلی در اکوسیستم در حال حاضر حمایت خود را بدون هیچ گونه مخالفت قابل توجهی اعلام کرده‌اند. اجرای فنی در طول ارتقاء Hegotá آزمون واقعی خواهد بود.

  • حمایت نهادها از کاهش زمان بلاک اتریوم

    حمایت نهادها از کاهش زمان بلاک اتریوم

    حمایت از تسریع اتریوم با کاهش زمان بلاک

    یک سازمان غیرانتفاعی از کاهش زمان بلاک در شبکه اتریوم حمایت کرده و دلیل آن را افزایش فعالیت نهادی در این شبکه قرارداد هوشمند عنوان کرده است.

    این سازمان که با نام “Ethereum Institutional” شناخته می‌شود، حمایت خود را از پیشنهاد Ethlabs برای کاهش زمان بلاک و ایجاد اتریومی سریع‌تر، به منظور مقابله با رقابت فزاینده از سوی شبکه‌های دیگر اعلام کرد.

    این سازمان غیرانتفاعی روز جمعه در پستی در شبکه اجتماعی X نوشت: “اتریوم را سریع‌تر کنیم.” این سازمان استدلال کرد که کاهش زمان بلاک با توجه به “افزایش فعالیت نهادی در زنجیره” ضروری است.

    روز پنجشنبه، Ethlabs مقاله‌ای منتشر کرد که در آن از ۲۰ بنیان‌گذار امور مالی غیرمتمرکز (DeFi) نقل قول شده بود و حمایت گسترده‌ای از EIP-8198، که با نام “Quick Slots” نیز شناخته می‌شود، نشان می‌داد. این پیشنهاد در ابتدا به دنبال کاهش زمان بلاک اتریوم از ۱۲ ثانیه به ۱۰ ثانیه است.

    سایر شبکه‌های بلاکچین نیز در حال کار بر روی طرح‌های مشابهی برای کاهش زمان بلاک هستند. روز دوشنبه، اکثریت دارندگان توکن Zcash از کاهش زمان هدف بلاک این شبکه از ۷۵ ثانیه به ۲۵ ثانیه حمایت کردند.

    در ماه اوت، سولانا زمان اسلات خود را از ۴۰۰ میلی‌ثانیه به ۳۵۰ میلی‌ثانیه کاهش داد. در ماه ژوئن، بنیاد سولانا برنامه‌هایی را برای کاهش زمان اسلات از ۴۰۰ میلی‌ثانیه به ۲۰۰ میلی‌ثانیه به اشتراک گذاشت و استدلال کرد که این امر باعث بهبود تأخیر و تسریع تأییدیه‌ها در شبکه بلاکچین خواهد شد.

    EIP-8198 در ماه مارس تدوین شد و برای گنجانده شدن در ارتقاء Hegotá در جلسه توسعه‌دهندگان اصلی اتریوم در ۶ اوت پیشنهاد شد. Ethlabs اعلام کرد که مشخصات این پیشنهاد را با کد اصلی ادغام کرده و در حال بررسی وابستگی‌های احتمالی پایین‌دستی برای کمک به “ورود معنادار آن به دامنه Hegotá” است.

    توسعه‌دهندگان اتریوم ممکن است اواخر سال ۲۰۲۶، پس از Glamsterdam، که احتمالاً یکی از مهم‌ترین ارتقاءهای سال برای بهبود مقیاس‌پذیری و استحکام شبکه اصلی است، پیاده‌سازی Hegotá را آغاز کنند.

  • سولانا: سرعت بلاک ۱۷٪ افزایش یافت، تراکنش‌ها سریع‌تر

    سولانا: سرعت بلاک ۱۷٪ افزایش یافت، تراکنش‌ها سریع‌تر

    س mejoras در شبکه اصلی سولانا: زمان تولید بلاک سریع‌تر و تأثیر آن بر برنامه‌های غیرمتمرکز

    شبکه اصلی سولانا (Solana) رسماً زمان تولید هر بلاک (slot time) را از ۳۰۰ میلی‌ثانیه به ۲۵۰ میلی‌ثانیه کاهش داده است. این اقدام منجر به افزایش ۱۷ درصدی سرعت تولید بلاک شده و تعداد بلاک‌های تولید شده در هر ثانیه را از حدود ۳.۳ به ۴ عدد افزایش داده است. ظرفیت کلی تراکنش‌ها در شبکه ثابت مانده است، اما تأیید تراکنش‌ها سریع‌تر شده و تأخیر در قیمت‌گذاری کاهش یافته است که به طور مستقیم از صرافی‌های غیرمتمرکز (DEX) و برنامه‌های اوراکل بهره‌مند می‌شود.

    جزئیات فنی و تأثیرات

    کاهش زمان تولید بلاک، سومین مرحله از کاهش مداوم زمان تولید بلاک در سولانا است. مراحل قبلی این زمان را از ۴۰۰ میلی‌ثانیه به ۳۵۰ میلی‌ثانیه و سپس به ۳۰۰ میلی‌ثانیه کاهش داده بودند.

    بر اساس طرح پیشنهادی SIMD-0525، میزان محاسبات و داده‌های مجاز در هر اسلات به نسبت طول اسلات کاهش می‌یابد. به عبارت دیگر، با وجود افزایش ۱۷ درصدی تعداد بلاک‌ها در هر ثانیه، حجم کاری قابل گنجاندن در هر بلاک به همان نسبت کاهش یافته است. این بدان معناست که حداکثر ظرفیت پردازش شبکه در عمل تغییر چندانی نکرده است. توسعه‌دهندگان این وضعیت را به افزایش دفعات حرکت قطارها در یک ایستگاه تشبیه می‌کنند؛ قطارها با فاصله زمانی کمتری حرکت می‌کنند، اما ظرفیت هر قطار ثابت است. در نتیجه، مسافران مجبور نیستند مدت طولانی‌تری در سکو منتظر بمانند، اما تعداد کل مسافرانی که در یک ساعت از ایستگاه عبور می‌کنند، یکسان باقی می‌ماند.

    در مکانیزم سولانا، اعتبارسنج‌ها (validators) به نوبت نقش رهبر (leader) را برای بسته‌بندی بلاک‌ها بر عهده می‌گیرند. اکنون دوره رهبری پیوسته هر رهبر از چهار اسلات (۱.۲ ثانیه) به چهار اسلات (۱ ثانیه) کاهش یافته است. این امر انتقال حق اولویت‌بندی تراکنش‌ها را سریع‌تر می‌کند و زمان کنترل ترتیب تراکنش‌ها توسط یک اعتبارسنج واحد را کاهش می‌دهد که به نوبه خود تأثیر مثبتی بر تمرکززدایی و مقاومت در برابر سانسور دارد.

    منافع مستقیم برای برنامه‌های غیرمتمرکز

    سریع‌تر شدن روند تولید بلاک مستقیماً به نفع صرافی‌های غیرمتمرکز (DEX)، بازارسازان خودکار (AMM) و بازارهای مبتنی بر اوراکل است. در این برنامه‌ها، تأخیر چند صد میلی‌ثانیه‌ای می‌تواند تعیین‌کننده اجرای یک تراکنش با قیمت مورد انتظار یا شکست کامل آن باشد. با کاهش زمان تولید بلاک، کیف پول‌ها، صرافی‌ها و برنامه‌های معاملاتی می‌توانند سریع‌تر به آخرین داده‌های روی زنجیره دسترسی پیدا کنند و پنجره زمانی لغزش قیمت در تراکنش‌های سواپ (swap) کوچک‌تر می‌شود. از نظر تئوری، این امر می‌تواند زیان‌های ناشی از تراکنش‌های ناموفق و لغزش قیمت را کاهش دهد.

    چالش‌ها و هزینه‌ها

    شبکه سریع‌تر بدون هزینه نیست. در سطح زیرساخت، نیاز به پردازش و ذخیره‌سازی تعداد بیشتری بلاک مجزا وجود دارد. برنامه‌هایی که زمان را با استفاده از ضرایب ثابت اسلات تخمین می‌زنند، ممکن است با انحراف مواجه شوند. مهم‌تر از آن، زمان اعتبار هش بلاک (blockhash) در ساعت فعلی کوتاه‌تر شده است. این بدان معناست که فضای عملیاتی برای امضای آفلاین تراکنش‌ها، تأییدهای با تأخیر و سایر فرآیندهای معاملاتی که نیاز به دخالت انسانی دارند، کمتر می‌شود. برای کاربران سازمانی یا کسانی که نیازهای امنیتی بالایی دارند، این امر ممکن است نیازمند بازطراحی فرآیندها باشد.

    چشم‌انداز آینده

    از آنجایی که هر دوره (epoch) همچنان به طور ثابت ۴۳۲,۰۰۰ اسلات دارد، کاهش زمان تولید بلاک باعث شده است که طول واقعی هر دوره از حدود ۳۶ ساعت به ۳۰ ساعت کاهش یابد. تیم توسعه‌دهنده سولانا در ابتدا قصد داشت زمان تولید بلاک را بیشتر به ۲۰۰ میلی‌ثانیه (۵ اسلات در ثانیه، دوره حدود ۲۴ ساعت) کاهش دهد، اما در حال حاضر تاریخ دقیقی برای راه‌اندازی آن در شبکه اصلی مشخص نشده است. توسعه‌دهندگان اعلام کرده‌اند که تنها در صورتی مرحله بعدی را پیش خواهند برد که مرحله ۲۵۰ میلی‌ثانیه‌ای به طور پایدار عمل کند و نرخ پرش بلاک (block-skip rate) در محدوده قابل قبولی باقی بماند.

    موفقیت این ارتقا نه در “سرعت تئوری” بلکه در داده‌های عملی نهفته است. معیارهای کلیدی که باید در دوره‌های بعدی مورد توجه قرار گیرند عبارتند از: آیا نرخ پرش بلاک افزایش می‌یابد؟ آیا تأخیر همگام‌سازی گره‌های اعتبارسنج افزایش می‌یابد؟ آیا نرخ تراکنش‌های ناموفق در DEX کاهش می‌یابد؟ اگر مرحله ۲۵۰ میلی‌ثانیه‌ای به طور پایدار اجرا شود، این یک دستاورد عملی دیگر برای سولانا در رقابت بر سر عملکرد بلاکچین‌های عمومی خواهد بود، به ویژه در مقایسه با سایر بلاکچین‌هایی که بر توان عملی بالا تأکید دارند. برعکس، اگر نرخ پرش بلاک از کنترل خارج شود، تیم توسعه‌دهنده ممکن است مجبور شود هدف ۲۰۰ میلی‌ثانیه‌ای را به تعویق بیندازد یا حتی پارامترهای فعلی را مجدداً ارزیابی کند.

    مقالات مرتبط:

    از سرزمین میم‌کوین‌ها تا محبوب وال استریت، سولانا در مسیر تحول گام برمی‌دارد
    اهمیت شبکه رابین‌هود: در ۱۱ هفته به افسانه سولانا رسید
    عملکرد، امنیت، بین‌زنجیره‌ای: چه تغییرات جدیدی در زیرساخت بلاکچین‌های عمومی شایسته توجه است؟
    ارتقای شبکه اصلی سولانا: زمان تولید بلاک به ۳۵۰ میلی‌ثانیه کاهش می‌یابد، از Epoch 1020 اعمال می‌شود
    معرفی ماشین مجازی اتریوم، آیا BRC 2.0 می‌تواند شکوه گذشته توکن‌های بیت‌کوین را تکرار کند؟

  • پشتیبانی رسمی CUDA از Rust: انویدیا آخرین قطعه پازل را تکمیل کرد، توسعه‌دهندگان هوش مصنوعی دشوارتر جدا می‌شوند

    پشتیبانی رسمی CUDA از Rust: انویدیا آخرین قطعه پازل را تکمیل کرد، توسعه‌دهندگان هوش مصنوعی دشوارتر جدا می‌شوند

    ان‌ویدیا درهای هسته محاسباتی GPU را به روی Rust باز کرد؛ مسیرهای SIMT و Tile موازی پیش می‌روند

    همزمان با پیوستن به هیئت مدیره بنیاد Rust، ان‌ویدیا با گشودن درهای خود به روی زبان برنامه‌نویسی Rust، قصد دارد خندق دفاعی CUDA را عمیق‌تر کند.

    ان‌ویدیا در تاریخ ۸ سپتامبر (۱۷ شهریور) در وبلاگ فنی رسمی خود اعلام کرد که بخش‌های حیاتی برنامه‌نویسی GPU اکنون مستقیماً با استفاده از Rust قابل نوشتن هستند. اکوسیستم CUDA پیش از این از ابزارهای توسعه بالغ C++ و Python بهره می‌برد، اما هسته‌هایی که مستقیماً روی کارت گرافیک اجرا می‌شوند (kernel)، استثنا بودند. توسعه‌دهندگان می‌توانستند از Rust به این هسته‌ها فراخوانی کنند، اما قادر به نوشتن آن‌ها با Rust نبودند.

    پشتیبانی از Rust در CUDA، این پازل ناتمام را تکمیل می‌کند.

    روز بعد، در ۹ سپتامبر (۱۸ شهریور)، ربکا رامبول، مدیر اجرایی بنیاد Rust، در مراسم افتتاحیه RustConf 2026 در مونترال اعلام کرد که ان‌ویدیا و بنیاد سولانا به عضویت پلاتینیوم بنیاد درآمده‌اند. این عضویت با پرداخت سالانه ۳۲۵ هزار دلار، شامل یک کرسی در هیئت مدیره برای هر کدام می‌شود. این دو خبر در واقع یک پیام را منتقل می‌کنند: ان‌ویدیا قصد دارد خود را در حلقه تصمیم‌گیری هسته‌ای Rust جای دهد، نه اینکه صرفاً به عنوان یک کاربر باقی بماند.

    لایه سیستم هوش مصنوعی، شامل موتورهای استنتاج، زیرساخت‌های استقرار، درایورها و محیط‌های اجرای عامل‌ها، به سرعت در حال مهاجرت به Rust هستند. دلیل این امر روشن است: Rust قادر است در زمان کامپایل (یعنی پیش از اجرای واقعی برنامه و در مرحله کامپایل، کامپایلر خطاهای مربوط به استفاده از حافظه را شناسایی می‌کند) دسته‌ای از اشکالات را شناسایی کند، بدون اینکه عملکرد را فدا کند.

    درایور لینوکس ان‌ویدیا، Nova، با Rust نوشته شده است و هسته چارچوب استنتاج NVIDIA Dynamo نیز بر پایه Rust بنا شده است. اما هسته‌های برنامه‌نویسی GPU همواره آخرین قلمرو تسخیر نشده باقی مانده بود: توسعه‌دهندگان می‌توانستند از Rust به آن‌ها فراخوانی کنند، اما مجبور بودند آن‌ها را با CUDA C++ یا زبان‌های دیگر بنویسند.

    پشتیبانی از Rust در CUDA، این شکاف را پر می‌کند. این اختلاف زبانی بین لایه سیستم و هسته‌های محاسباتی، خود نوعی بدهی فنی پنهان است: هر چقدر هم که لایه بالایی با Rust به دقت نوشته شود، به محض عبور از مرز و ورود به هسته برنامه، تضمین‌های اولیه از بین می‌روند و مشکلات اغلب تا زمان استقرار در محیط عملیاتی واقعی خود را نشان نمی‌دهند.

    ان‌ویدیا در این مرحله دو مسیر را پیش گرفته است که با دو مدل برنامه‌نویسی موجود در CUDA مطابقت دارد. مسیر اول، cuda-oxide است که با SIMT (Single Instruction, Multiple Threads – به زبان ساده، توسعه‌دهنده فقط مشخص می‌کند که “یک رشته چه کاری باید انجام دهد” و GPU به طور خودکار هزاران رشته را برای انجام همان کار ایجاد می‌کند) مطابقت دارد. این رایج‌ترین روش برای توسعه‌دهندگان CUDA C++ است. cuda-oxide کل این فرآیند را به کامپایلر Rust منتقل می‌کند و تا PTX (زبان اسمبلی سطح پایین که GPU قادر به درک آن است) کامپایل می‌شود.

    مسیر دوم، cutile-rs است که با Tile (بلوک – به زبان ساده، یک مدل برنامه‌نویسی جدیدتر است که در آن توسعه‌دهنده فقط مشخص می‌کند “یک بلوک کامل از داده‌ها چه کاری باید انجام دهد” و کامپایلر خود تصمیم می‌گیرد که چگونه آن را برای اجرا به سخت‌افزار تقسیم کند) مطابقت دارد. ان‌ویدیا در وبلاگ خود توصیه می‌کند که توسعه‌دهندگان اولویت را به Tile بدهند، زیرا تشخیص تفاوت‌های معماری به کامپایلر سپرده می‌شود؛ تنها در صورتی که واقعاً نیاز به مدیریت دستی رشته‌ها و حافظه مشترک باشد، باید به SIMT بازگشت.

    هر دو مسیر بر یک اصل شرط‌بندی می‌کنند: استفاده از قوانین مالکیت Rust برای جلوگیری از شرایط رقابتی (race conditions – اشکالاتی که در آن‌ها چندین رشته به طور همزمان سعی در خواندن و نوشتن یک بخش از حافظه دارند و با تغییر ترتیب، داده‌ها اشتباه می‌شوند) در زمان کامپایل. ان‌ویدیا در وبلاگ خود نشان می‌دهد که اگر یک بافر خروجی مشترک هم به عنوان ورودی و هم به عنوان خروجی به طور همزمان ارسال شود، cuda-oxide مستقیماً با شکست کامپایل مواجه می‌شود؛ cutile-rs حتی سخت‌گیرانه‌تر عمل می‌کند و مالکیت داده‌ها را در طول کل مرز فراخوانی هسته دنبال می‌کند، نه فقط در لحظه فراخوانی.

    این نوع اشکالات در گذشته اغلب تا زمان آنلاین شدن برنامه و افزایش ترافیک به ندرت رخ می‌دادند، اما اکنون در همان لحظه نوشتن کد شناسایی می‌شوند.

    با این حال، ان‌ویدیا خود اذعان دارد که هیچ‌کدام از این دو پروژه هنوز برای استقرار در محیط رسمی آماده نیستند. cuda-oxide در حال حاضر در مرحله آلفای اولیه قرار دارد و برای کامپایل نیاز به ابزارهای توسعه nightly (نسخه‌های آزمایشی کامپایلر Rust که روزانه توسط تیم رسمی Rust به‌روزرسانی می‌شوند، قابلیت‌های جدیدتری دارند اما تضمین سازگاری ندارند) با نسخه‌های ثابت دارد و حافظه مشترک هنوز باید با استفاده از unsafe (سینتکس ناامن که مکانیزم‌های حفاظتی کامپایلر را موقتاً غیرفعال می‌کند و مسئولیت صحت را به توسعه‌دهنده واگذار می‌کند) مدیریت شود.

    cutile-rs پیشرفت سریع‌تری داشته و می‌تواند روی نسخه استاندارد Rust اجرا شود و نیازی به ابزارهای nightly ندارد. این پروژه قبلاً توسط موتور استنتاج Grout از Hugging Face و پروژه mistral.rs به کار گرفته شده است؛ اما ان‌ویدیا صراحتاً اعلام کرده است که رابط‌های API همچنان در حال تغییر هستند و پوشش‌دهی هنوز کامل نیست. به عبارت دیگر، هر دو مسیر در حال حاضر در مرحله‌ای قرار دارند که “کار می‌کنند، اما عجله‌ای برای سرمایه‌گذاری روی آن‌ها نیست.”

    با کنار هم قرار دادن این دو خبر، استراتژی ان‌ویدیا کاملاً قابل درک است. CUDA عمیق‌ترین خندق دفاعی ان‌ویدیا محسوب می‌شود. در سال‌های اخیر، AMD با ROCm، گوگل با TPU و پشته نرم‌افزاری خود، و بسیاری از شرکت‌های ابری با طراحی تراشه‌های اختصاصی، همگی در تلاش بوده‌اند تا از CUDA عبور کنند. هدف همه آن‌ها این بود که با دور زدن CUDA، قدرت قیمت‌گذاری و نفوذ ان‌ویدیا را کاهش دهند.

    در ابتدا این نگرانی وجود داشت که با اجبار CUDA به باز شدن به روی اکوسیستم‌های دیگر، مزیت قفل‌شدگی ان‌ویدیا تضعیف شود؛ اما رویکرد ان‌ویدیا در این مورد کاملاً برعکس است. این شرکت CUDA را در جای خود رها نکرده تا مورد حمله رقبا قرار گیرد، بلکه به طور فعالانه آستانه استفاده را به زبانی که مهندسان سیستم با آن آشنا هستند، کاهش داده است. با این کار، توسعه‌دهندگان Rust نیز به داخل دیوارهای CUDA کشیده می‌شوند. زبان تغییر کرده است، اما بلیط ورود همچنان توسط ان‌ویدیا صادر می‌شود و کسانی که به دنبال دلیلی برای خروج بودند، اکنون دلیل کمتری برای این کار دارند.

  • مدل Jev چیست؟ هوش مصنوعی تصمیم‌گیرنده از بنیان‌گذاران OpenAI: ۲۰۰ برابر سریع‌تر، ۴۰۰ برابر ارزان‌تر

    مدل Jev چیست؟ هوش مصنوعی تصمیم‌گیرنده از بنیان‌گذاران OpenAI: ۲۰۰ برابر سریع‌تر، ۴۰۰ برابر ارزان‌تر

    TypeSafe AI: مدل جدیدی که با سرعت و هزینه کمتر، قضاوت‌های احتمالی را انجام می‌دهد

    شرکت TypeSafe AI که توسط یکی از بنیان‌گذاران ChatGPT تأسیس شده است، اخیراً از مدل جدیدی به نام Jev رونمایی کرده است. این مدل برخلاف مدل‌های زبانی بزرگ (LLM) که برای گفتگو طراحی شده‌اند، صرفاً بر انجام قضاوت‌های احتمالی تمرکز دارد و ادعا می‌شود صدها برابر سریع‌تر و ارزان‌تر از LLMها عمل می‌کند. این نوآوری در جامعه فناوری با استقبال و بحث‌های فراوانی روبرو شده است.

    Jev: قضاوت سریع، نه گفتگو

    یکی از موارد نمایشی که توسط TypeSafe AI منتشر شده، نشان می‌دهد که مدل Jev برای انجام یک وظیفه قضاوت مشابه، تنها ۰.۱۱۴ ثانیه زمان صرف کرده است، در حالی که GPT-5.6 Terra برای همین کار ۸.۵۶۶ ثانیه زمان نیاز داشته است. این مثال، پیام اصلی TypeSafe AI را برجسته می‌کند: همه وظایف هوش مصنوعی نیازمند یک مغز متفکر و قادر به گفتگو نیستند.

    Jev که در تاریخ ۱۵ سپتامبر به طور رسمی معرفی شد، اولین محصول TypeSafe AI و “مدل سیستم یک” (System One Model) نام گرفته است. این مدل نه برای نوشتن مقاله، نه برای گفتگو و نه برای چت‌های روزمره طراحی شده است؛ بلکه تنها یک کار را انجام می‌دهد: قضاوت سریع.

    بنیان‌گذار و چشم‌انداز TypeSafe AI

    TypeSafe AI در سال ۲۰۲۴ در سانفرانسیسکو تأسیس شد. دیوگو آلِمیدا (Diogo Almeida)، بنیان‌گذار این شرکت، یکی از محققان سابق OpenAI است که در توسعه تکنیک‌هایی مانند RLHF (آموزش مدل با بازخورد انسانی)، InstructGPT، ChatGPT و GPT-4 نقش داشته و شاهد انتقال این محصولات از آزمایشگاه به دنیای واقعی بوده است.

    شریک DCVC به نکته کلیدی اشاره می‌کند: TypeSafe AI قصد دارد مدل‌های قدرتمندتر را به فناوری‌ای تبدیل کند که توسعه‌دهندگان بتوانند به طور قابل اعتماد و در مقیاس بزرگ در محصولات خود ادغام کنند، نه اینکه صرفاً در ویدئوهای نمایشی باقی بمانند. به عبارت دیگر، هوشمندی مدل دیگر بزرگترین چالش نیست؛ بلکه جلب “اعتماد” توسعه‌دهندگان به قضاوت‌های مدل، مسئله‌ای است که در ادامه راه با آن روبرو خواهند شد.

    آلمیدا خود این موضوع را صریح‌تر بیان می‌کند: “من سال‌ها صرف تحقیق بر روی مدل‌هایی کردم که در تعامل با انسان‌ها بهتر عمل کنند. اما اگر هوش مصنوعی قرار است اساساً نحوه انجام کارها را تغییر دهد، انسان نباید تنها مصرف‌کننده هوش باشد.”

    نام‌گذاری و فلسفه Jev

    نام Jev دارای دو لایه ارجاع و همچنین بیانگر انتظارات شرکت از خود است. “سیستم یک” از طبقه‌بندی روانشناس دانیل کانمن در کتاب “تفکر، سریع و کند” وام گرفته شده است: سیستم یک، شهودی و سریع است، در حالی که سیستم دو، استدلالی و کند. Jev با سیستم یک هم‌راستا است و مسئولیت قضاوت‌هایی را بر عهده دارد که نیازی به تفکر عمیق ندارند و باید در کسری از ثانیه پاسخ داده شوند.

    نام “Jev” نیز از “پارادوکس جِوُنز” (Jevons paradox) که توسط اقتصاددان ویلیام استنلی جِوُنز مطرح شد، گرفته شده است: هرچه یک منبع کارآمدتر و ارزان‌تر استفاده شود، انسان‌ها به جای صرفه‌جویی، بیشتر از آن استفاده می‌کنند. TypeSafe به وضوح امیدوار است که Jev نیز مسیری مشابه را طی کند؛ به طوری که با ارزان بودن، توسعه‌دهندگان آن را در گوشه و کنار بیشتری از برنامه‌های خود که پیش از این از هوش مصنوعی در آن‌ها صرفه‌جویی می‌شد، به کار گیرند.

    منطق عملیاتی و خروجی Jev

    از نظر منطق عملیاتی، Jev و مدل‌های زبانی بزرگ (LLM) دو سازوکار متفاوت دارند. LLMها با تولید توکن به توکن، مانند تایپ کردن، پاسخ‌ها را تولید می‌کنند. در مقابل، Jev یک وضعیت متنی بدون فرمت ثابت را به عنوان ورودی دریافت کرده و با یک محاسبه موازی، مستقیماً “تصمیمات احتمالی نوع‌بندی شده” را خروجی می‌دهد. شکل ظاهری پاسخ از قبل با استفاده از یک “اسکیما” (Schema) که می‌توان آن را به عنوان قوانین فیلدهای یک فرم پرکردنی در نظر گرفت، تعریف شده است.

    این مدل تنها سه نوع عملیات اولیه را ارائه می‌دهد: انتخاب (انتخاب یکی از حداکثر ۲۵۵ گزینه از پیش تعیین شده)، امتیازدهی (اختصاص یک امتیاز عددی) و قضاوت درست/نادرست (همراه با احتمال). هر پاسخ با یک امتیاز اطمینان کالیبره شده همراه است. به زبان ساده، این امتیاز به اندازه‌ای دقیق است که در آمار تعداد زیادی از موارد، برنامه‌ها می‌توانند از آن برای تصمیم‌گیری در مورد تأیید خودکار، ارجاع به انسان یا بازبینی توسط مدل استدلالی استفاده کنند.

    روش آموزش و ادعای عدم توهم

    در روش آموزش، TypeSafe روش اختصاصی خود به نام RLCD (یادگیری تقویتی تصمیم‌گیری کالیبره شده) را ابداع کرده است که با روش‌های رایج صنعت مانند RLHF و RLVR متفاوت است. از آنجایی که فرمت خروجی از ابتدا توسط اسکیما قفل شده است، TypeSafe ادعا می‌کند که Jev قادر به تولید خطاهای نوعی نیست و حتی از عبارت “توهم‌زا نیست” استفاده می‌کند.

    سرعت و هزینه: مزیت اصلی Jev

    اعداد و ارقام، بزرگترین نقطه قوت Jev هستند. این شرکت ادعا می‌کند که تأخیر سرتاسری این مدل بین ۷۰ تا ۵۰۰ میلی‌ثانیه است، در حالی که LLMها برای وظایف مشابه به ۳ تا ۳۲۹ ثانیه زمان نیاز دارند. این به معنای سرعت ۴۰ تا ۲۰۰ برابر بیشتر و هزینه ۴۰ تا ۴۰۰ برابر کمتر است.

    TypeSafe با مقایسه میانگین عملکرد GPT-6 Astra و Claude Fable 5.1، اعلام کرده است که Jev تا ۱۹۳.۶ برابر سریع‌تر و ۴۴۴.۶ برابر ارزان‌تر است و در عین حال، سطح هوشمندی آن “مشابه” LLMهای موجود است. از نظر قیمت، Jev برای هر میلیون توکن ورودی ۰.۰۴۲ دلار دریافت می‌کند و خروجی رایگان است. در مقایسه، LLMها معمولاً بین ۰.۲۰ تا ۱۰ دلار هزینه دارند و GPT-5.6 Terra برای ورودی ۲ دلار و برای خروجی ۱۲ دلار هزینه دارد. TypeSafe ادعا می‌کند که هزینه Jev ۲۳۸ برابر ارزان‌تر از قیمت پایه Fable 5.1 است.

    محدودیت‌ها و کاربردهای واقعی

    البته، سرعت و ارزانی بالا با محدودیت‌های قابل توجهی همراه است. Jev قادر به گفتگو، نوشتن کد یا توضیح دلیل قضاوت خود نیست. این مدل فقط متن را پردازش می‌کند و قادر به خواندن تصاویر، صدا یا ویدئو نیست. پاسخ‌های آن نیز همیشه در چارچوب گزینه‌های از پیش تعریف شده قفل شده‌اند و نمی‌توانند از آن خارج شوند.

    امتیاز کالیبره شده نیز صرفاً دقت کلی در آمار دسته‌های بزرگ را بیان می‌کند و تضمین نمی‌کند که هر مورد خاص درست باشد. رسانه فناوری The Register اشاره کرده است که مقایسه “عدم توهم‌زایی” با LLMها منصفانه نیست، زیرا خروجی ساختاریافته و زبان طبیعی دو چیز کاملاً متفاوت هستند و عدم وجود توهم به معنای هوشمندی واقعی‌تر مدل نیست. در حال حاضر، Jev در مرحله دسترسی زودهنگام قرار دارد و کاربران باید در وب‌سایت رسمی برای ورود به لیست انتظار ثبت‌نام کنند و هنوز همه به آن دسترسی ندارند.

    کاربردهای واقعی Jev، آن دسته از وظایفی هستند که از ابتدا باید توسط برنامه قضاوت می‌شدند، اما به دلیل نبود گزینه‌های بهتر، به اجبار در LLMها گنجانده شده‌اند. این شامل مواردی مانند طبقه‌بندی و مسیریابی درخواست‌ها، پردازش فاکتورها، تفکیک تماس‌های پشتیبانی مشتری، فیلتر کردن هشدارهای امنیتی، پردازش داده‌های حجیم، بررسی خروجی عوامل هوش مصنوعی، شناسایی حملات “فرار از زندان” (jailbreak) یا ایجاد یک لایه حفاظتی برای خروجی LLMها می‌شود. TypeSafe حتی Jev را برای نمایش سرعت بالای خود در بازی DOOM به کار گرفته است که با ۱۰ پرس‌وجو در ثانیه، هزینه تقریبی ۷ دلار در ساعت دارد.

  • اوپن‌ای‌آی از «آسترا برای حقوق» رونمایی کرد؛ سه شرکت حقوقی بزرگ آمریکا در حال استفاده

    اوپن‌ای‌آی از «آسترا برای حقوق» رونمایی کرد؛ سه شرکت حقوقی بزرگ آمریکا در حال استفاده

    OpenAI از «Astra for Law» رونمایی کرد: جهش چشمگیر در دقت هوش مصنوعی برای امور حقوقی

    شرکت OpenAI از محصول جدید خود با نام «Astra for Law» رونمایی کرده است که با ترکیب مدل GPT-6 Astra، یک فهرست جستجوی حقوقی جامع و دستورالعمل‌های سفارشی، دقت پاسخگویی در مسائل حقوقی را از ۳۸.۷ درصد به ۵۴.۰ درصد افزایش داده است. این ابزار نوآورانه، که با هدف ارتقای کارایی و دقت در حوزه حقوقی طراحی شده است، پیش از این توسط موسسات حقوقی بزرگی مانند Sullivan & Cromwell و Cooley مورد آزمایش قرار گرفته و شرکت‌هایی چون Harvey و Legora نیز در حال ادغام API آن در محصولات خود هستند.

    پیشرفت قابل توجه در دقت

    در ارزیابی‌های انجام شده توسط پلتفرم Legal Research Bench شرکت Vals AI، مدل استاندارد GPT-6 Astra در پاسخ به سوالات حقوقی با استفاده از جستجوی اینترنتی، تنها به دقت ۳۸.۷ درصد دست یافته بود. اما با به‌کارگیری «Astra for Law»، که به طور تخصصی برای امور حقوقی بهینه‌سازی شده است، دقت پاسخگویی به همان مجموعه ۲۰۰ سوال تحقیقاتی حقوقی در ایالات متحده به ۵۴.۰ درصد افزایش یافته است؛ این به معنای افزایشی ۴۰ درصدی است. این موفقیت مرهون یک فهرست جامع از قوانین و رویه‌های قضایی است که بیش از ۲۳۰ میلیون وب‌سایت را پوشش می‌دهد و به طور مداوم به‌روزرسانی می‌شود.

    معماری «Astra for Law»

    بر اساس اعلامیه رسمی OpenAI در روز پنجشنبه، «Astra for Law» یک مدل کاملاً جدید نیست، بلکه ترکیبی از مدل GPT-6 Astra، یک سیستم جستجوی حقوقی پیشرفته و مجموعه‌ای از دستورالعمل‌های سفارشی برای تحلیل و نگارش حقوقی است که در قالب یک «زیرساخت هوش مصنوعی حقوقی» ارائه می‌شود.

    فهرست جستجوی حقوقی این سیستم قادر به کاوش در پرونده‌های قضایی، قوانین موضوعه، مقررات، قواعد دادگاهی و تصمیمات اداری در ایالات متحده است و بیش از ۲۳۰ میلیون منبع را در بر می‌گیرد.

    بخش کلیدی این سیستم، همکاری با CourtListener، زیرمجموعه سازمان غیرانتفاعی Free Law Project، است. این همکاری به فهرست جستجو اجازه می‌دهد تا بیش از ۹۹.۹ درصد از پرونده‌های قضایی معتبر و دارای سابقه در ایالات متحده را پوشش دهد. این بدان معناست که پرونده‌هایی که پیش از این تنها از طریق پایگاه‌های داده پولی مانند Westlaw و Lexis قابل دسترسی بودند، اکنون در ابزار جستجوی چت‌بات گنجانده شده‌اند.

    در میان ۲۰۰ سوال مورد بررسی، در سوالات مربوط به پرونده‌های قضایی، «Astra for Law» توانست ۲۴ درصد بیشتر از GPT-6 Astra که صرفاً از جستجوی اینترنتی استفاده می‌کرد، پرونده‌های مرجع مرتبط را پیدا کند. همچنین در مجموعه پاراگراف‌های هدف که به صورت دستی بررسی شده بودند، تا ۵۴ درصد پاراگراف‌های مرتبط‌تری را بازیابی کرد.

    OpenAI در اعلامیه خود مثالی را ارائه داده است: در پاسخ به درخواست «یافتن نزدیک‌ترین پرونده مرجع و نگارش یک یادداشت حقوقی»، «Astra for Law» دو پرونده قضایی را که به طور دقیق با حقایق پرونده مطابقت داشتند، شناسایی کرد. در مقابل، Claude Fable 5.1 در یک سناریوی حقوقی، حکمی را استناد کرد که قبلاً توسط دادگاه تجدیدنظر نقض شده بود و در یک سناریوی معاملاتی، اعلام کرد که قادر به یافتن پرونده مشابهی نیست.

    فراتر از یافتن پرونده‌ها

    یافتن پرونده‌های قضایی تنها گام اول است. OpenAI در اعلامیه خود توضیح داده است که دستورالعمل‌های داخلی تحلیل و نگارش حقوقی سیستم، به مدل کمک می‌کند تا نتایج تحقیقات را با حقایق خاص مشتریان تطبیق دهد، دلایل اصلی احکام را از نکات حاشیه‌ای متمایز کند، پرونده‌های نامطلوب را مدیریت کند یا بندهای استثنای قرارداد را توضیح دهد که چگونه ریسک را بین طرفین منتقل می‌کنند.

    سه موسسه حقوقی بزرگ در ایالات متحده، «Astra for Law» را در فرآیندهای کاری روزمره خود ادغام کرده‌اند.

    اکوسیستم و دسترسی

    در بخش اکوسیستم، OpenAI اعلام کرده است که با ۲۶ توسعه‌دهنده افزونه همکاری کرده است تا ChatGPT را به ابزارهای رایج در موسسات حقوقی مانند Relativity، Clio، iManage، Intapp و DeepJudge متصل کند. همچنین汤森路透 (Thomson Reuters) سیستم مدیریت پرونده HighQ خود را به ChatGPT متصل کرده و در آینده نزدیک یک اتصال‌دهنده CoCounsel Legal را معرفی خواهد کرد.

    علاوه بر این، ۹ افزونه و ۴۷ مهارت توسط توسعه‌دهندگان جامعه برای استفاده وکلا در دسترس قرار گرفته است. ChatGPT for Word نیز در همان روز به طور رسمی عرضه شد. مشتریان API مانند Harvey و Legora نیز تأیید کرده‌اند که «Astra for Law» را در محصولات خود ادغام خواهند کرد.

    «Astra for Law» ابتدا از طریق برنامه «Trusted Access» به موسسات حقوقی منتخب ارائه خواهد شد و برای ChatGPT Enterprise و Codex در دسترس خواهد بود، و سپس API آن نیز منتشر خواهد شد.

    بر اساس گزارش وب‌سایت حقوقی LawSites، در مرحله اولیه، دسترسی به این ابزار برای موسسات Am Law 200، یعنی ۲۰۰ موسسه حقوقی برتر از نظر درآمد در ایالات متحده، محدود خواهد بود و قیمت‌گذاری آن هنوز اعلام نشده است. در منوی انتخاب مدل‌های ChatGPT، این ابزار با نام «GPT-6 Astra Law» و در API با نام gpt-6-astra-law شناخته می‌شود.

    OpenAI در اعلامیه خود بیان کرده است که موسسات حقوقی واجد شرایط، توافق‌نامه عدم نگهداری داده (Zero Data Retention، ZDR) را برای API دریافت خواهند کرد، به این معنی که سوابق استفاده ذخیره یا برای آموزش مدل استفاده نخواهد شد. همچنین سوابق استفاده از ChatGPT Enterprise به طور پیش‌فرض توسط انسان بررسی نخواهد شد. در زمینه حاکمیت، OpenAI با Latham & Watkins برای طراحی مکانیسم‌های مجوزدهی اطلاعات، دیوارهای حائل، دستورالعمل‌های مشتری و نظارت بر موسسات حقوقی همکاری می‌کند و همچنین با Wachtell, Lipton, Rosen & Katz برای ادغام تخصص این موسسه در دعاوی حقوقی و حقوق شرکت‌ها در تحقیقات پیشرفته همکاری دارد.

    چالش‌ها و ملاحظات

    با این حال، این اعداد مقایسه‌ای هنوز صرفاً نتایج ارزیابی خود OpenAI در اعلامیه رسمی هستند و توسط شخص ثالث بازتولید نشده‌اند. از سوی دیگر، نرخ دقت ۵۴.۰ درصد به این معناست که «Astra for Law» همچنان در نزدیک به نیمی از سوالات به طور کامل پاسخگو نیست، که این میزان در حوزه حقوقی که تفاوت‌های جزئی در کلمات می‌تواند منجر به پیروزی یا شکست در پرونده شود، هنوز نمی‌تواند اطمینان کامل را جلب کند.

    نگرانی جامعه حقوقی نسبت به «توهمات هوش مصنوعی» بی‌دلیل نیست. تنها چند روز قبل از انتشار این اعلامیه، یک وکیل در ایالت نیومکزیکو آمریکا به دلیل استفاده از محتوای تولید شده توسط ChatGPT که شامل «شهادت‌های ساختگی» بود، توسط قاضی به اتهام تمسخر دادگاه جریمه شد. OpenAI در اعلامیه خود بر «منابع معتبر و قابل اتکا که وکلا می‌توانند خودشان بررسی کنند» تأکید کرده است، اما در نهایت مسئولیت بررسی بر عهده انسان خواهد بود.

  • فِگِر هلیکس ۲.۵ را منتشر کرد؛ نرخ موفقیت ربات‌ها به ۵۶ درصد رسید

    فِگِر هلیکس ۲.۵ را منتشر کرد؛ نرخ موفقیت ربات‌ها به ۵۶ درصد رسید

    Figure AI از مدل هوش مصنوعی جدیدی رونمایی کرد که ربات‌های انسان‌نما را قادر می‌سازد وظایف خانگی را در خانه‌های ناآشنا انجام دهند

    به نظر می‌رسد رباتی انسان‌نما که بتواند وارد خانه یک غریبه شود و بدون آموزش اختصاصی برای آن خانه، تخت را مرتب کند، در قلمرو داستان‌های علمی-تخیلی باشد. اما شرکت Figure AI قصد دارد این تصور را تغییر دهد.

    در تاریخ ۱۷ سپتامبر ۲۰۲۶، Figure از Helix 2.5، یک مدل کنترل هوش مصنوعی جدید برای ربات‌های انسان‌نمای خود رونمایی کرد که در انجام سه وظیفه خانگی در ۳۰ خانه در منطقه خلیج سانفرانسیسکو که قبلاً ندیده بود، نرخ موفقیت ۵۶ درصدی را به دست آورد. این رقم از ۲۳۷ تکمیل موفقیت‌آمیز از مجموع ۴۲۰ تلاش به دست آمده است و در مقایسه با مدل پایه‌ای ۹ درصدی که از ابتدا برای انجام همین وظایف آموزش دیده بود، پیشرفت قابل توجهی محسوب می‌شود.

    این مدل بر روی سه کار خانگی تمام‌بدن آزمایش شد: مرتب کردن تخت، تا کردن حوله و مرتب کردن اتاق نشیمن. هر وظیفه نیازمند آن است که ربات در مورد اشیائی که قبلاً با آن‌ها مواجه نشده و در پیکربندی‌های فضایی که هرگز ندیده، استدلال کند.

    مرتب کردن تخت با ۹۴ موفقیت از ۱۴۰ تلاش و نرخ موفقیت ۶۷ درصدی، در صدر نتایج قرار گرفت. تا کردن حوله با ۶۲ درصد و ۸۷ موفقیت از ۱۴۰ تلاش، در رتبه دوم قرار گرفت. مرتب کردن اسباب‌بازی‌ها دشوارترین وظیفه بود و با ۵۶ موفقیت از ۱۴۰ تلاش، به نرخ ۴۰ درصدی دست یافت.

    سخت‌افزار مورد استفاده برای اجرای این سیستم، پلتفرم Figure 03، نسل فعلی ربات‌های انسان‌نمای این شرکت است. Helix 2.5 لایه نرم‌افزاری است که بر روی آن قرار گرفته و به طور همزمان وظایف ادراک، تصمیم‌گیری و کنترل فیزیکی را بر عهده دارد.

    نکته کلیدی در اینجا، قابلیت تعمیم “بدون نمونه” (zero-shot generalization) است. ربات هیچ آموزش اضافی خاصی برای این خانه‌ها یا اشیاء درون آن‌ها دریافت نکرده است.

    جهش عملکرد از ۹ درصد به ۵۶ درصد به چیزی بازمی‌گردد که Figure آن را Index می‌نامد؛ یک مجموعه داده پیش‌آموزشی که از ضبط رفتار انسان ساخته شده است. Figure پلتفرم داده Index را در تاریخ ۲۵ آگوست ۲۰۲۶، تقریباً سه هفته قبل از اعلامیه Helix 2.5، به صورت عمومی راه‌اندازی کرد.

    Helix 2.5 همچنین بر اساس تکرار قبلی ساخته شده است. Figure در ژانویه ۲۰۲۶، Helix 02 را راه‌اندازی کرد و معماری کنترلی را ایجاد نمود که اکنون Helix 2.5 آن را گسترش می‌دهد.

    برت ادکاک، مدیرعامل Figure، Helix 2.5 را مهم‌ترین پروژه‌ای که Figure تاکنون انجام داده، توصیف کرده است.

    نرخ موفقیت ۵۶ درصدی برای تعمیم بدون نمونه در محیط‌های واقعی، آشفته و متنوع خانگی، واقعاً قابل توجه است. این بدان معناست که ربات تقریباً نیمی از مواقع شکست می‌خورد، که با استاندارد قابلیت اطمینان مورد نیاز برای استفاده روزمره در خانه فاصله زیادی دارد.

    مقایسه در اینجا بین یک ربات و یک خدمتکار خانگی انسان نیست. بلکه مقایسه بین رباتی است که بر روی داده‌های رفتار عمومی انسان آموزش دیده و همین سخت‌افزار بدون هیچ پیش‌آموزش معنی‌داری است. رفتن از یک موفقیت از یازده تلاش به بیش از یک موفقیت از دو تلاش، بدون دیدن محیط از قبل، یک نتیجه مهندسی قابل توجه است.