Tag: نوآوری فناوری

  • مهندس با GPT-6 آسترا رمز ۲۱۷ ساله ناپلئون را گشود

    مهندس با GPT-6 آسترا رمز ۲۱۷ ساله ناپلئون را گشود

    مهندسی که با هوش مصنوعی رمز نامفهوم ناپلئون را گشود

    یک مهندس در شرکت SentinelOne با استفاده از مدل GPT-6 Astra و حدود ۶ ساعت زمان پردازش، موفق شد نامه‌ای رمزگذاری شده را که به دستور ناپلئون برای ژنرال مارمونت نوشته شده بود و به مدت ۲۱۷ سال دست‌نخورده باقی مانده بود، از روی یک تصویر منتشر شده در مجله‌ای در سال ۱۹۶۹ رمزگشایی کند.

    پیش‌زمینه: رمزگشایی تلگراف آلمانی و رمز اسکاتلندی

    این اولین بار نیست که هوش مصنوعی به حل معماهای تاریخی کمک می‌کند. پیش از این، مدل GPT-6 Astra در عرض دو روز موفق به رمزگشایی یک تلگراف آلمانی شد که ۲۱ سال حل نشده باقی مانده بود. همچنین، کلود فابل موفق به شکستن یک رمز باستانی اسکاتلندی شد که ۳۷۳ سال حل نشده بود.

    نامه‌ای که ۲۱۷ سال ناخوانا ماند

    این نامه، که به مدت ۲۱۷ سال برای هیچ‌کس قابل درک نبود، سرانجام توسط مهندسی که پیش از این هیچ تجربه‌ای در رمزگشایی نداشته، و با صرف حدود ۶ ساعت زمان پردازش مدل، رمزگشایی شد.

    کارتر چرچ، مهندس هوش مصنوعی در شرکت SentinelOne و با بیش از ده سال سابقه در حوزه امنیت سایبری، در اواخر سپتامبر در وبلاگ شخصی خود جزئیات این رمزگشایی را منتشر کرد. او با استفاده از مدل GPT-6 Astra، موفق شد یک نامه نظامی رمزگذاری شده مربوط به سال ۱۸۰۹، در دوران ناپلئون، را از روی یک تصویر اسکن شده بخواند.

    زمینه تاریخی نامه

    در فوریه ۱۸۰۹، اتریش تصمیم به جنگ گرفت و به این امید که نیروهای نخبه ناپلئون در اسپانیا گرفتار شده‌اند، دست به اقدام زد. مشکل ناپلئون در آن زمان، ژنرال مارمونت بود که با حدود ۱۳ هزار نفر (بر اساس تخمین خود ناپلئون) در سواحل غربی شبه جزیره بالکان در دالماسی، که سرزمینی اتریشی بود، منزوی شده بود. در روز آغاز جنگ، او دورافتاده‌ترین ژنرال امپراتوری محسوب می‌شد.

    در ۱۶ مارس، ناپلئون از پاریس به جانشین خود و فرماندار ایتالیا، اوژن دو بوآرنه، دستور داد تا با استفاده از رمز، نامه‌ای را برای مارمونت ارسال کند و موقعیت هر یک از نیروهای فرانسوی و متحدان را مشخص کند. این نامه توسط ستاد اوژن صادر شد و نه مستقیماً توسط ناپلئون.

    ساختار نامه و چالش‌های رمزگشایی

    سطر اول نامه به زبان فرانسوی واضح نوشته شده بود: «ژنرال مارمونت، شما باید نامه‌های مورخ ۸، ۱۴ و ۲۰ ماه جاری را دریافت کرده باشید.» پس از آن، ۲۴ سطر شامل اعداد، حروف و نمادهای ابداعی قرار داشت که کلید رمزگشایی آن هرگز منتشر نشد. این نامه تنها از طریق یک تصویر منتشر شده در مجله نظامی فرانسوی Revue historique des Armées در سال ۱۹۶۹ باقی مانده بود، که سال انتشار آن را نیز به اشتباه ۱۸۰۷ ذکر کرده بود.

    فهرست Cryptiana که توسط ساتوشی توموکویو نگهداری می‌شود و شامل رمزهای تاریخی حل نشده است، تنها به سطر اول این نامه اشاره کرده بود. یادداشت‌های دانیل بوردیو، رمزگشای دیگر، حتی صریح‌تر بود: «هیچ کاری نمی‌توان انجام داد، متن رمزگذاری شده در هیچ کجای قابل دسترسی منتشر نشده است.»

    نسخه اسکن شده این مجله در واقع در پایگاه داده علمی فرانسوی Persée به صورت عمومی در دسترس بود. این تصویر با ابعاد ۱۲۰۲ در ۱۸۳۶ پیکسل، هر نماد را حدود ۱۹ پیکسل در بر می‌گرفت. دانیل تانت، مورخ رمز فرانسوی، پیش از این ۳۳ جفت حرف را شناسایی کرده بود که امکان خواندن ۴۳۵ واحد را فراهم می‌کرد، که حدود یک سوم متن را شامل می‌شد. ۸۶۵ واحد باقی مانده، یعنی حدود دو سوم، باید با استفاده از مدل و از خود متن نامه استخراج می‌شد.

    پیچیدگی‌های رمز هموفونیک

    نامه شامل ۱۳۰۰ واحد رمزگذاری شده و ۱۵۵ نماد مختلف بود. این یک رمز هموفونیک (homophonic cipher) بود: حروف رایج دارای چندین نماد قابل تعویض بودند که شمارش فراوانی را بی‌فایده می‌کرد.

    روش رمزگشایی با هوش مصنوعی

    مدل Astra ابتدا تصویر را به ستون‌هایی تقسیم کرد، نمادها را خواند و ۱۷۵ علامت موقت را مشخص کرد. سپس تشخیص داد که کدام نمادها دو بار نوشته شده‌اند و پس از ادغام آن‌ها، فرآیند رمزگشایی آغاز شد. رونویسی و تحلیل رمز معمولاً دو تخصص مجزا هستند، اما در این مورد به صورت یکپارچه انجام شد.

    ابزار اصلی مورد استفاده، شبیه‌سازی تبرید (simulated annealing) بود. به طور خلاصه، ابتدا یک تطابق تصادفی بین نمادها حدس زده شد و سپس با تنظیمات جزئی، امتیازدهی بر اساس فراوانی ترکیب حروف در زبان فرانسوی انجام شد. اگر امتیاز بهبود می‌یافت، تغییرات حفظ می‌شدند و گاهی اوقات پاسخ‌های ضعیف‌تر نیز پذیرفته می‌شدند تا از گیر افتادن زودهنگام جلوگیری شود. داده‌های مورد استفاده برای امتیازدهی، فراوانی ترکیب‌های ۳، ۴ و ۵ حرفی در آثار ویکتور هوگو، الکساندر دوما و خاطرات مارمونت بود.

    هنگامی که مشخص شد هر تلاشی برای تطابق نمادها، روانی زبان فرانسوی را مختل می‌کند، چرچ فرض کرد که آن‌ها «کلمات کامل» را نشان می‌دهند. این کلمات شامل عباراتی مانند “de”، “que”، “vous” و “général” بودند. نحوه خواندن هر نماد نیز با تمام موقعیت‌های آن در تصویر مقایسه می‌شد و تنها در صورتی که همه آن‌ها معتبر بودند، حفظ می‌شد.

    مهم‌ترین گام، اثبات معکوس بود. او خاطرات مارمونت و تمام متون دوران ناپلئون را از داده‌های امتیازدهی حذف کرد و دوباره اجرا کرد و به همان تفسیر دست یافت. این نشان می‌داد که کلید رمز با تکیه بر «دیدن پاسخ» در داده‌های زبانی به دست نیامده است.

    نتایج رمزگشایی و تأیید تاریخی

    نامه رمزگشایی شده هفت استقرار نیرو را فهرست می‌کرد: ۴۰ هزار نفر از ارتش باواریا، ۳۰ هزار نفر از ارتش لهستان، ارتش ساکسون، ۸۰ هزار نفر از نیروهای داووت، ۶۰ هزار نفر از نیروهای ماسنا، ۴۰ هزار نفر از نیروهای اودینو، و همچنین پیشروی ارتش روسیه به سمت اتریش. ترتیب و اعداد کاملاً با شماره ۱۴۹۰۸ از مجموعه نامه‌های ناپلئون که در سال ۱۸۶۵ منتشر شد، یعنی همان دستور ۱۶ مارس، مطابقت داشت. توموکویو در ۲۰ سپتامبر پاسخ را دریافت کرد، آن را بررسی کرد و این مورد را به عنوان «حل شده» در فهرست خود ثبت کرد و سال انتشار را به ۱۸۰۹ تغییر داد.

    در واقع، مواد لازم از قبل در دسترس بود: جدول تطبیقی تانت، مجموعه نامه‌ها که در دهه ۱۸۶۰ منتشر شد، و خاطرات مارمونت که در پروژه گوتنبرگ موجود بود. یک متخصص صبور در سال ۱۹۷۰ می‌توانست این کار را انجام دهد. مشکل این بود که این امر نیازمند هفته‌ها زمان تخصصی بود: دانش زبان فرانسوی آن دوره، توانایی تمرکز بر ۱۳۰۰ نماد دست‌نویس، و مهارت‌های آماری، که همگی بر روی یک تصویر متمرکز می‌شدند.

    افرادی که این مهارت‌ها را داشتند، احتمالاً موضوعات مهم‌تری برای رسیدگی داشتند. مانع اصلی، دشواری نبود، بلکه هزینه بود؛ اما اکنون این مانع توسط هوش مصنوعی شکسته شده است و تنها کنجکاوی شماست که در مقابل فهرست موارد حل نشده قرار دارد.

    مقالات مرتبط

    • مدل استدلال OpenAI رمز و راز ۸۰ ساله ریاضیات را گشود؛ سه ریاضیدان برجسته تأیید کردند.
    • هوش مصنوعی کنترل دنیای ریاضیات را به دست می‌گیرد؟ مدل Astra OpenAI ۱۰ معمای صد ساله را حل کرد؛ دانشمندان نگرانند: سهم بشریت از بین برود.
    • OpenAI مدل اصلی نسل بعدی خود، Astra، را معرفی کرد: ۱۰ مسئله ریاضی که ۱۰ سال بشر را به چالش کشیده بود، یکجا حل شد.
    • GPT-6 Astra در آزمون ورودی دانشگاه کره نمره کامل گرفت! GPT-5.6 با ۱.۵ امتیاز اختلاف دوم شد.
    • مهندسان Claude، Grok و GPT را به خودروی واقعی متصل کردند! تنها Astra توانست کامل اجرا شود.
  • ریپل سئول: حریم خصوصی XRPL، هوش مصنوعی و ارتقاهای جدید

    ریپل سئول: حریم خصوصی XRPL، هوش مصنوعی و ارتقاهای جدید

    ریپل از ارتقاهای کلیدی XRP Ledger برای پذیرش نهادی و توسعه‌دهندگان خبر داد

    در کنفرانس اخیر در آسیا، ریپل اعلام کرد که XRP Ledger (XRPL) برای موج جدیدی از پذیرش نهادی و توسعه‌دهندگان آماده می‌شود و ارتقاهای کلیدی شامل تراکنش‌های محرمانه، دسته‌بندی تراکنش‌ها و زیرساخت اختصاصی برای عوامل هوش مصنوعی در دستور کار قرار دارند.

    این شرکت قصد دارد شبکه خود را فراتر از پرداخت‌های ساده گسترش داده و به سمت موارد استفاده کامل‌تر نهادی و خودکار حرکت کند.

    از جمله مهم‌ترین تحولات جدید، تراکنش‌های محرمانه با استفاده از اثبات‌های دانش صفر (zero-knowledge proofs) است. طبق ارائه‌ای که در پلتفرم X توسط حسابی که اخبار کنفرانس را پوشش می‌دهد، منتشر شد، شفافیت کامل در زنجیره (on-chain) از گذشته مشکلاتی را برای موسسات مالی سنتی ایجاد کرده است که نمی‌توانند تمام جزئیات تراکنش‌های پیچیده را به صورت عمومی افشا کنند.

    قابلیت تراکنش محرمانه برنامه‌ریزی شده به موسسات اجازه می‌دهد تا گردش کارهای تراکنش حساس خود را خصوصی نگه دارند و در عین حال اعتبار آن‌ها را برای شبکه و نهادهای نظارتی مربوطه اثبات کنند.

    شرکت پشت XRP همچنین در تلاش است تا شبکه خود را از طریق تأیید رسمی (formal verification)، آزمایش‌های خصمانه (adversarial testing) و دسته‌بندی تراکنش‌ها (transaction batching) برای عملیات مالی پیچیده‌تر مناسب‌تر سازد. این امر امکان دسته‌بندی چندین تراکنش یا عملیات و اجرای آن‌ها را به صورت “همه یا هیچ” فراهم می‌کند، که می‌تواند کارایی را برای توسعه‌دهندگان و موسساتی که برنامه‌های پیچیده‌تری بر روی XRP Ledger می‌سازند، بهبود بخشد.

    در حالی که اعلامیه‌های فوق ممکن است برای بسیاری از دنبال‌کنندگان تحولات اخیر ریپل و XRPL غافلگیرکننده نباشد، دخالت هوش مصنوعی می‌تواند دیگران را شگفت‌زده کند. آیو آکین‌یله، مدیر ارشد مهندسی ریپل، اظهار داشت که عوامل هوش مصنوعی در حال حاضر فعالیت قابل توجهی را در XRPL ایجاد کرده‌اند و حجم تراکنش‌های مرتبط با آن از ۱۱ میلیون تراکنش فراتر رفته است.

    ریپل همچنین در حال توسعه زیرساختی است که به طور خاص برای عوامل خودکار طراحی شده تا رشد بیشتری را تقویت کند. این شامل هویت‌های قابل تأیید، مجوزها و کنترل‌های هزینه، و کیف پول‌های هوشمند امن است که قادر به نگهداری هر دو ارز XRP و استیبل‌کوین‌ها هستند.

    هدف این است که به عوامل هوش مصنوعی اجازه داده شود تا به طور مستقل تراکنش انجام دهند و در عین حال در چارچوب تدابیر امنیتی از پیش تعریف شده عمل کنند. سرعت تسویه حساب XRP Ledger که در سخنرانی اصلی حدود سه تا پنج ثانیه توصیف شد، می‌تواند آن را به ویژه برای پرداخت‌های ماشین به ماشین و سایر فعالیت‌های مالی خودکار مناسب سازد.

    این تحولات متناسب با XRPL، به دنبال یک مقاله کاری از بانک تسویه حساب‌های بین‌المللی (Bank of International Settlements) است که استفاده از آن را برای تأیید آمارهای رسمی در زنجیره و تقویت یکپارچگی داده‌ها بدون اطلاع‌رسانی به سیستم‌های موجود، بررسی کرده بود.

  • سرمایه‌گذار زن آرک: با آغاز هزینه‌کرد ایجنت‌ها، زیرساخت‌های هوش مصنوعی در کانون توجه سرمایه‌گذاران

    سرمایه‌گذار زن آرک: با آغاز هزینه‌کرد ایجنت‌ها، زیرساخت‌های هوش مصنوعی در کانون توجه سرمایه‌گذاران

    کاتى وود: قانون جدید سرمایه‌گذاری “عوامل را دنبال کنید”

    کاتى وود، هم‌بنیان‌گذار ARK Invest، در نشست Robinhood Summit قانون جدید سرمایه‌گذاری را با عنوان “عوامل را دنبال کنید” (Follow the Agents) مطرح کرد. او معتقد است با تکامل عوامل هوش مصنوعی از پاسخ‌گویی به پرسش‌ها به سمت هزینه‌کرد مستقل، سرمایه‌گذاران باید بر زیرساخت‌های مالی مورد استفاده آن‌ها تمرکز کنند.

    تکامل از “دنبال کردن توسعه‌دهندگان” به “دنبال کردن عوامل”

    کاتى وود در سال‌های گذشته بارها به سرمایه‌گذاران توصیه کرده بود که “توسعه‌دهندگان را دنبال کنند” (follow the developers) و با رصد تحرکات آن‌ها، روندهای فناوری را پیش‌بینی کنند. او در نشست Robinhood Summit که این هفته در هیوستون برگزار شد، توصیه‌ای به‌روز شده ارائه داد: “ممکن است ما به طور فزاینده‌ای درباره دنبال کردن عوامل صحبت کنیم.”

    زیرساخت‌های مالی در عصر عوامل هوش مصنوعی

    پرسش اصلی که در پس این جمله نهفته است این است که وقتی هوش مصنوعی دیگر صرفاً به دنبال یافتن پاسخ برای انسان‌ها نیست، بلکه شروع به هزینه کردن برای آن‌ها می‌کند، زیرساخت‌های مالی چگونه تغییر خواهند کرد؟

    شرکت BlackRock در گزارشی که در ماه سپتامبر در مورد هم‌پوشانی هوش مصنوعی و دارایی‌های دیجیتال منتشر کرد، استدلال مشابهی را مطرح کرده است. این بزرگترین موسسه مدیریت دارایی جهان معتقد است که عوامل هوش مصنوعی ممکن است نیازهای جدیدی را برای “سیستم‌های پرداخت مخصوص ماشین” ایجاد کنند.

    یک عامل هوش مصنوعی ممکن است نیاز به پرداخت هزینه‌های فراخوانی API، خرید داده از خدمات دیگر، یا اجاره منابع محاسباتی داشته باشد، و این تراکنش‌ها نمی‌توانند هر بار منتظر تأیید انسانی بمانند. BlackRock معتقد است که استیبل‌کوین‌ها و بلاک‌چین می‌توانند یکی از راه‌های پردازش این پرداخت‌ها باشند.

    استیبل‌کوین‌ها می‌توانند به صورت ۲۴ ساعته و بدون وقفه تراکنش انجام دهند و پروتکل‌های پرداخت بلاک‌چین می‌توانند امکان انتقال مستقیم مبالغ کم بین نرم‌افزارها را فراهم کنند. پروتکل x402 که توسط Coinbase راه‌اندازی شده است، نمونه‌ای از این طراحی‌ها است که به طور خاص برای پرداخت ماشین‌ها برای دسترسی به خدمات آنلاین مانند داده‌ها یا API طراحی شده است.

    حضور عوامل هوش مصنوعی در فضای رمزارز

    عوامل هوش مصنوعی در حال حاضر در برخی گوشه‌های فضای رمزارز ظاهر شده‌اند. برایان آرمسترانگ، مدیرعامل Coinbase، در پلتفرم X اعلام کرد که “Grok در حال حاضر پیشروترین مشتری معامله‌گر عامل (agentic trader) در Coinbase است”، اما جزئیات بیشتری ارائه نکرد.

    این بدان معناست که مدل Grok از xAI در حال اجرای خودکار معاملات از طریق عوامل هوش مصنوعی است، حداقل در مرحله آزمایشی یا اولیه. اگر در آینده مدل‌های هوش مصنوعی بیشتری با الگوی مشابه در صرافی‌های رمزارز فعالیت کنند، حجم معاملات و الگوهای رفتاری ممکن است دچار تغییرات ساختاری شوند.

    رقابت بین شبکه‌های باز و اکوسیستم‌های بسته

    با این حال، باید توجه داشت که استیبل‌کوین‌ها و بلاک‌چین‌ها بازار پرداخت عوامل هوش مصنوعی را به تنهایی در اختیار نخواهند داشت. Stripe، Visa، Google و OpenAI همگی در حال توسعه قابلیت‌هایی برای خرید و پرداخت توسط عوامل هوش مصنوعی هستند. BlackRock نیز در گزارش خود به صراحت بیان کرده است که سیستم‌های پرداخت سنتی همچنان مهم خواهند بود.

    این در واقع رقابت بین “شبکه باز در مقابل اکوسیستم بسته” است. بلاک‌چین‌هایی مانند اتریوم یک شبکه مالی مشترک را ارائه می‌دهند که برای عوامل هوش مصنوعی، اپلیکیشن‌ها و شرکت‌های مختلف قابل استفاده است و نیازی نیست هر شرکت هوش مصنوعی سیستم پرداخت بسته خود را بسازد. در مقابل، غول‌های فناوری تمایل دارند کل فرآیند را در اکوسیستم خود تکمیل کنند؛ عوامل هوش مصنوعی توسط آن‌ها آموزش داده می‌شوند، پرداخت‌ها توسط آن‌ها پردازش می‌شود و داده‌ها در پلتفرم آن‌ها باقی می‌مانند.

    شاخص‌های کلیدی برای سرمایه‌گذاران

    اگر عوامل هوش مصنوعی واقعاً به بازیگران اصلی اقتصادی تبدیل شوند، رصد محل تراکنش آن‌ها و شبکه‌های پرداختی که استفاده می‌کنند، می‌تواند معیاری برای سنجش کاربرد واقعی استیبل‌کوین‌ها و بلاک‌چین‌ها باشد.

    جهت‌گیری فعلی نشان می‌دهد که استیبل‌کوین‌ها و بلاک‌چین‌ها در سناریوهای پرداخت “ماشین به ماشین، ۲۴ ساعته، ۷ روز هفته، با حجم کم و فرکانس بالا” مزیت طبیعی دارند. پرداخت هزینه‌های API، خرید داده، یا اجاره توان محاسباتی توسط عوامل هوش مصنوعی با خرید کارت اعتباری توسط انسان متفاوت است؛ نیازی به صورت‌حساب پایان ماه، تأیید دستی، یا تسویه بین مناطق زمانی مختلف نیست. این‌ها مواردی هستند که استیبل‌کوین‌ها در آن‌ها مهارت دارند.

    متغیرهای کلیدی: نظارت و قابلیت همکاری

    اما متغیرهای کلیدی در این میان، نظارت و قابلیت همکاری هستند. اگر پرداخت‌های عوامل هوش مصنوعی مشمول چارچوب AML/KYC شوند، مزیت استیبل‌کوین‌ها ممکن است تضعیف شود؛ و اگر پلتفرم‌های اصلی هوش مصنوعی ترجیح دهند فقط با سیستم‌های پرداخت خاصی ادغام شوند، استدلال شبکه باز زیر سوال می‌رود. در ۱ تا ۲ سال آینده، شواهد بیشتری در مورد این نقاط مشاهده‌ای ظهور خواهد کرد.

  • سیلبرس با طراحی تراشه ۵ نانومتری در مقیاس ویفر، از گلوگاه‌های تامین تراشه هوش مصنوعی عبور کرد

    سیلبرس با طراحی تراشه ۵ نانومتری در مقیاس ویفر، از گلوگاه‌های تامین تراشه هوش مصنوعی عبور کرد

    رقابت در حوزه سخت‌افزار هوش مصنوعی عمدتاً بر سر قطعات کمیاب بوده است. شرکت Cerebras Systems تلاش می‌کند با عدم نیاز به بسیاری از این قطعات، در این رقابت پیروز شود.

    رویکرد متفاوت Cerebras

    تراشه‌های مقیاس ویفری این شرکت از حافظه با پهنای باند بالا (HBM)، بسته‌بندی پیشرفته CoWoS و تولید در فرآیند ۳ نانومتری اجتناب می‌کنند. این‌ها سه گلوگاه اصلی صنعت در حال حاضر هستند. Cerebras مسیری متفاوت را در پیش گرفته است. تراشه‌های WSE-3 و مشتق آن WSE-3T بر اساس فرآیند ۵ نانومتری TSMC ساخته شده‌اند. تمام حافظه این تراشه‌ها به جای استفاده از پشته‌های جداگانه HBM، به صورت SRAM بر روی خود تراشه قرار دارد.

    مشخصات چشمگیر WSE-3

    WSE-3 در مارس ۲۰۲۴ معرفی شد. مشخصات آن بیشتر شبیه به یک طرح شهری است تا یک برگه مشخصات تراشه: ۹۰۰,۰۰۰ هسته هوش مصنوعی، ۴۴ گیگابایت حافظه SRAM روی تراشه و تقریباً ۴ تریلیون ترانزیستور. تمام این‌ها در مساحتی معادل ۴۶,۲۲۵ میلی‌متر مربع جای گرفته‌اند.

    ادعای سرعت بی‌سابقه

    اندرو فلدمن، مدیرعامل این شرکت، استدلال کرده است که این طراحی در جایی که بیشترین اهمیت را برای مشتریان دارد، یعنی سرعت تولید پاسخ توسط مدل‌های هوش مصنوعی، نتیجه‌بخش است. او در ژوئن ۲۰۲۶ این معماری را اینگونه توصیف کرد: “سریع‌ترین استنتاج در جهان به میزان یک مرتبه بزرگی.” یافته‌های تحقیقاتی ادعای فلدمن را به عنوان افزایش سرعت تولید توکن و حذف کندی‌های معمول در طراحی‌های مبتنی بر GPU توصیف می‌کنند.

    سفارش‌های عظیم و رشد درآمد

    تا ژوئن ۲۰۲۶، این شرکت گزارشی از پشتوانه سفارش ۲۵.۴ میلیارد دلاری ارائه داده است. بیش از ۲۰ میلیارد دلار از این مبلغ مربوط به یک قرارداد چندساله با OpenAI است.

    Cerebras همچنین اعلام کرده است که بیش از ۶۰۰ مگاوات ظرفیت مرکز داده، چه فعال و چه قرارداد شده، در اختیار دارد. طبق یافته‌های تحقیقاتی، درآمد این شرکت در سه ماهه دوم سال مالی، تقریباً دو برابر سال گذشته بوده است.

    در سپتامبر ۲۰۲۶، Cerebras موافقت کرد که سیستم‌های CS-4 را برای ظرفیتی حدود ۱۰۰ مگاوات به Gimlet Labs عرضه کند. این شرکت همچنین توافق‌نامه‌ای بلندمدت با General Compute منعقد کرده است که استقرار آن برای سه ماهه اول سال ۲۰۲۷ برنامه‌ریزی شده است.

    تمام این تحولات پس از عرضه اولیه سهام Cerebras در بورس نزدک در ماه مه ۲۰۲۶ صورت گرفته است. از زمان عرضه، این شرکت شروع به گسترش تولید در ایالات متحده و ایجاد مشارکت‌ها برای افزایش ظرفیت عملیاتی کرده است.

    تمرکز بر ظرفیت مراکز داده

    یافته‌های تحقیقاتی نشان می‌دهند که تقاضا برای زیرساخت هوش مصنوعی به طور فزاینده‌ای به فضای مراکز داده، برق و ساخت‌وساز وابسته است، نه صرفاً به در دسترس بودن تراشه‌ها. این موضوع توضیح می‌دهد که چرا Cerebras اکنون به جای تعداد تراشه، در مورد ظرفیت بر حسب مگاوات صحبت می‌کند. رقم ۶۰۰ مگاوات و تعهد حدود ۱۰۰ مگاواتی Gimlet Labs معیارهایی از توان و فضای فیزیکی هستند.

    چالش‌های پیش رو

    برای سرمایه‌گذاران Cerebras، سوال اصلی اجرای تعهدات است. پشتوانه سفارش ۲۵.۴ میلیارد دلاری یک وعده است، نه درآمد، و تبدیل آن به درآمد به ساخت، تأمین برق و راه‌اندازی مراکز داده طبق برنامه بستگی دارد. یافته‌های تحقیقاتی به هزینه‌های راه‌اندازی مراکز داده به عنوان چالشی که شرکت در تلاش برای غلبه بر آن است، اشاره می‌کنند.

    تمرکز مشتریان، دومین نکته‌ای است که باید مورد توجه قرار گیرد. با بیش از ۲۰ میلیارد دلار از پشتوانه سفارش که به OpenAI گره خورده است، سلامت این رابطه واحد وزن قابل توجهی دارد. قراردادهایی مانند Gimlet Labs و General Compute به تنوع بخشیدن به ترکیب کمک می‌کنند، هرچند در مقایسه بسیار کوچکتر هستند.

    در زمینه عملکرد، ادعای فلدمن مبنی بر استنتاج با مرتبه بزرگی، با بررسی مشتریانی که بارهای کاری واقعی را اجرا می‌کنند، مورد ارزیابی قرار خواهد گرفت. حافظه SRAM روی تراشه بسیار سریع است، اما ۴۴ گیگابایت برای هر تراشه یک بودجه ثابت است و نحوه مقیاس‌پذیری سیستم‌ها برای بزرگترین مدل‌ها، میزان پذیرش گسترده این طراحی را تعیین خواهد کرد.

  • محققان متا، دوک و یو‌سی دیویس شاخه‌های خودبهبود برای بهینه‌سازی عامل رونمایی کردند

    محققان متا، دوک و یو‌سی دیویس شاخه‌های خودبهبود برای بهینه‌سازی عامل رونمایی کردند

    محققان متا، دانشگاه دوک و دانشگاه کالیفرنیا، دیویس، ایده جدیدی برای بهبود عامل‌های هوش مصنوعی دارند. به جای تمرکز بر خود مدل، آن‌ها پیشنهاد می‌کنند که چارچوب اطراف مدل را بهبود بخشند و از چندین تیم خود-بهبوددهنده به جای یک تیم واحد استفاده کنند.

    بهبود عملکرد عامل‌های هوش مصنوعی با رویکرد چند شاخه‌ای

    پیش‌چاپ این تحقیق با عنوان «ترکیبی از شاخه‌های خود-بهبوددهنده برای بهینه‌سازی چارچوب عامل» (Mixture of Self-Improving Branches for Agent Harness Optimization)، بهبود ۳۴.۸ درصدی نسبی را در استدلال ریاضی در سطح المپیاد گزارش کرده است. این رویکرد دقت مدل Gemini 3 Flash را از ۴۶.۰ درصد به ۶۲.۰ درصد افزایش داده است، بدون اینکه نیازی به بازآموزی خود مدل باشد.

    به طور رسمی‌تر، «چارچوب عامل» (agent harness) به چارچوب کدنویسی گفته می‌شود که مدل زبان بزرگ را احاطه می‌کند. این چارچوب شامل دستورات (prompts) دریافتی مدل، ابزارهایی که می‌تواند فراخوانی کند، متنی که برای مشاهده در اختیار دارد و نحوه اجرای اقداماتش می‌شود.

    «بهینه‌سازی چارچوب» (harness optimization) به عمل جستجوی خودکار برای نسخه بهتر این پوشش کد اشاره دارد. مقاله جدید که در تاریخ ۲۹ سپتامبر ۲۰۲۶ در arXiv با شناسه 2609.37834v1 منتشر شده است، مستقیماً بر اساس سیستمی پیشین به نام Meta-Harness بنا شده است.

    Meta-Harness که در تاریخ ۳۰ مارس ۲۰۲۶ منتشر شد، پیش از این در معیارهای مختلف عملکرد بهتری نسبت به روش‌های سنتی داشته است. کار جدید استدلال می‌کند که یک مسیر جستجوی واحد، بخشی از پتانسیل عملکرد را نادیده می‌گیرد.

    بنابراین، محققان جستجو را به چندین شاخه تخصصی تقسیم کردند. هر شاخه به طور مستقل تکامل می‌یابد، با زیرمجموعه‌ای متمایز از داده‌های توسعه و سیاست خاص خود برای پیشنهاد تغییرات.

    این شاخه‌ها همچنین از تاریخچه خود درس می‌گیرند. هر شاخه مواردی را که در آن‌ها بر رقبای خود برتری یافته است، حفظ می‌کند و استراتژی خود را بر اساس عملکرد تلاش‌های قبلی اصلاح می‌کند.

    این موضوع سوال واضحی را مطرح می‌کند: چه کسی متخصص را انتخاب می‌کند؟ پاسخ یک «مسیریاب» (router) است. در زمان استقرار، این مسیریاب بهترین سر شاخه را برای هر ورودی دریافتی انتخاب می‌کند.

    کل فرآیند فقط بر روی داده‌های مجموعه توسعه اجرا می‌شود. نویسندگان گزارش می‌دهند که چارچوب‌های مکمل، بهبودهای خود را بدون هیچ دسترسی به مجموعه آزمون ارائه کرده‌اند.

    نتیجه برجسته در استدلال ریاضی در سطح المپیاد به دست آمد. دقت با استفاده از Gemini 3 Flash از ۴۶.۰ درصد به ۶۲.۰ درصد افزایش یافت، که نویسندگان آن را به عنوان یک بهبود ۳۴.۸ درصدی نسبی توصیف می‌کنند.

    این بهبودها به وظایف عاملی نیز منتقل شد. در Terminal-Bench 2.0، که عامل‌ها را در محیط خط فرمان آزمایش می‌کند، این سیستم افزایش ۱۱.۶ درصدی را ثبت کرد.

    SWE-bench Lite، یک معیار مهندسی نرم‌افزار، افزایش ۳.۸ درصدی را نشان داد.

    فهرست نویسندگان شامل Haoyu Dong، وابسته به Meta و دانشگاه دوک، و Zihao Lin، وابسته به Meta و UC Davis است. Lizhu Zhang و Zhuokai Zhao به عنوان نویسندگان مشترک آخر ذکر شده‌اند.

    این مقاله یک پیش‌چاپ است که در arXiv منتشر شده است. این بدان معناست که به صورت عمومی به اشتراک گذاشته شده است، اما لزوماً تحت بررسی رسمی همتایان قرار نگرفته است.

    جهش از ۴۶.۰ درصد به ۶۲.۰ درصد در ریاضیات دشوار، که بدون دستکاری وزن‌های مدل به دست آمده است، نشان می‌دهد که بهبودهای معنی‌دار می‌تواند از مهندسی محیطی که مدل در آن عمل می‌کند، حاصل شود.

    سوالات باز و قابل توجهی وجود دارد. اجرای و نگهداری چندین شاخه در حال تکامل به همراه یک مسیریاب احتمالاً پیچیدگی را افزایش می‌دهد، و نتایج مقاله از معیارهای خاص و یک مدل خاص به دست آمده است.

    Meta-Harness در مارس ۲۰۲۶ عرضه شد و در آن زمان نیز از روش‌های سنتی پیشی گرفته بود. تقریباً شش ماه بعد، جانشین آن ادعا می‌کند که از خود Meta-Harness بهتر عمل می‌کند.

  • اوپن‌ای‌آی دو بار پودی‌پای را تعلیق کرد

    اوپن‌ای‌آی دو بار پودی‌پای را تعلیق کرد

    فلیکس کیلیبرگ، یوتیوبر معروف به پپ‌دای‌پای، مدل هوش مصنوعی خود را عرضه کرد. او این مدل را «آژاکس» نامیده و ادعا می‌کند که در جریان توسعه آن، دو بار از سوی OpenAI اخراج شده است.

    عرضه مدل هوش مصنوعی آژاکس

    این مدل در حدود اول و دوم اکتبر ۲۰۲۶ عرضه شد. آژاکس یک دستیار کوچک و بدون سانسور است که برای اجرا بر روی کامپیوتر شخصی کاربر طراحی شده و نیازی به سرورهای ابری ندارد.

    مشخصات فنی و هدف آژاکس

    آژاکس یک مدل ۹ میلیارد پارامتری است. کیلیبرگ این مدل را از ابتدا نساخته، بلکه نسخه‌ای تنظیم‌شده از مدل پایه Qwen3.5-9B شرکت Alibaba است. هدف از توسعه آژاکس، ایفای نقش یک عامل خودمختار و دستیار در محیط کاری خودمیزبانی «اودیسئوس» است که کیلیبرگ در ماه مه ۲۰۲۶ راه‌اندازی کرده بود. وظایف این دستیار شامل جستجوی وب، مدیریت ایمیل، امور تقویم و فهرست وظایف است و قرار است همگی بر روی سخت‌افزارهای مصرفی اجرا شوند.

    حواشی پیرامون توسعه آژاکس

    عرضه این مدل با حواشی همراه بود. کیلیبرگ ادعا می‌کند که در طول توسعه آژاکس، حساب کاربری او دو بار از سوی OpenAI مسدود شده است. دلیل اعلام‌شده برای این اقدام، «تقطیر» (Distillation) بوده است؛ روشی که در آن پاسخ‌های یک مدل قدرتمند به عنوان داده آموزشی برای یک مدل کوچک‌تر استفاده می‌شود. در این مورد، ادعا می‌شود که خروجی‌های مدل‌های OpenAI، از جمله مدلی به نام «Sol»، برای تولید داده‌های آموزشی آژاکس به کار رفته است.

    آژاکس همچنین از ابزاری به نام Heretic برای فرآیندی موسوم به «تخریب‌گری» (Abliteration) استفاده می‌کند. این تکنیک برای کاهش تمایل مدل به رد کردن درخواست‌ها به کار می‌رود و باعث می‌شود مدل به سادگی پاسخ دهد. طبق یافته‌های تحقیقاتی، آژاکس همچنان محدودیت‌های ایمنی مشخصی را در برابر درخواست‌های مضر حفظ می‌کند. بنابراین، «بدون سانسور» در اینجا به معنای کمتر موعظه‌گرانه است، نه کاملاً بی‌قید و بند.

    فقدان مستندات و ابهامات

    در اوایل اکتبر ۲۰۲۶، چندین بخش استاندارد از یک عرضه مدل هوش مصنوعی غایب بود. آژاکس فاقد کارت مدل عمومی، معیارهای عملکرد منتشر شده، مجوز تایید شده برای وزن‌ها و لینک دانلود فوری بود.

    پروژه هوش مصنوعی کیلیبرگ با آژاکس آغاز نشد. اودیسئوس در ماه مه ۲۰۲۶ عرضه شد و محیطی خودمیزبانی را برای دستیار فراهم کرد. آژاکس عملاً مغزی است که او برای این بدنه ساخته است.

    روایت کیلیبرگ، در صورت صحت، نشان می‌دهد که شرایط OpenAI علیه یک توسعه‌دهنده فردی برجسته، نه فقط یک شرکت رقیب، اجرا شده است. یافته‌های تحقیقاتی حاکی از آن است که علاقه به سیستم‌های هوش مصنوعی خصوصی و متن‌باز همچنان در حال افزایش است. عرضه یک دستیار خانگی توسط خالقی با دامنه نفوذ کیلیبرگ، نمایش عمومی قابل توجهی برای این ایده است.

    مدلی که با تکنیک تخریب‌گری و مستندات محدود عرضه شده، بررسی نحوه عملکرد محدودیت‌های ایمنی آن را دشوار می‌سازد. همچنین، مدلی که گفته می‌شود بخشی از داده‌های آموزشی آن از خروجی‌های آزمایشگاه دیگری تأمین شده، ممکن است با پرسش‌هایی در مورد مجوز نهایی آن روبرو شود. کارت مدل و معیارهای عملکرد منتشر شده می‌توانند نشان دهند که آیا آژاکس مطابق با تبلیغات عمل می‌کند یا خیر. مجوز تایید شده و لینک دانلود نیز مشخص خواهند کرد که آیا این مدل به یک ابزار واقعاً باز تبدیل خواهد شد یا صرفاً یک نمایش باقی خواهد ماند.

  • مدیرعامل کاگنیشن: ۳۰ تا ۳۵ میلیون مهندس نرم‌افزار ۱۰ برابر سریع‌تر می‌شوند

    مدیرعامل کاگنیشن: ۳۰ تا ۳۵ میلیون مهندس نرم‌افزار ۱۰ برابر سریع‌تر می‌شوند

    کوجنیشن با هدف توانمندسازی ۳۵ میلیون مهندس نرم‌افزار، به ارزش ۴۸ میلیارد دلار دست یافت

    اسکات وو، مدیرعامل شرکت کوجنیشن (Cognition)، بازاری را هدف قرار داده که اکثر استارتاپ‌ها آرزوی آن را دارند: تقریباً تمام مهندسان نرم‌افزار در جهان. وو اعلام کرده است که این شرکت قصد دارد بهره‌وری حدود ۳۰ تا ۳۵ میلیون مهندس نرم‌افزار در سراسر جهان را افزایش دهد و میزان نرم‌افزاری که واقعاً ساخته می‌شود را گسترش بخشد. سرمایه‌گذاران نیز به نظر می‌رسد به این چشم‌انداز باور دارند. کوجنیشن در ماه مه ۲۰۲۶ بیش از ۱ میلیارد دلار سرمایه جذب کرد و ارزش‌گذاری آن به ۲۶ میلیارد دلار رسید.

    دور سرمایه‌گذاری ماه مه، پیش از ورود سرمایه جدید، ارزش کوجنیشن را ۲۵ میلیارد دلار تعیین کرده بود که با احتساب سرمایه جدید، به ۲۶ میلیارد دلار رسید. دور بعدی، سری E، که در اواخر سال ۲۰۲۶ انجام شد، بیش از ۲ میلیارد دلار سرمایه جذب کرد و ارزش کوجنیشن را به ۴۸ میلیارد دلار رساند. مجموع سرمایه‌گذاری‌های این شرکت اکنون از ۲.۵ میلیارد دلار فراتر رفته است.

    درآمد نیز همگام با رشد سرمایه‌گذاری پیش رفته است. درآمد سالانه در حال افزایش از ۴۹۲ میلیون دلار در ماه مه ۲۰۲۶ به بیش از ۱ میلیارد دلار تا سپتامبر ۲۰۲۶ رسید.

    محصول اصلی کوجنیشن، “دوین” (Devin) نام دارد؛ یک عامل هوش مصنوعی که برای مهندسی نرم‌افزار خودکار طراحی شده است. این شرکت ادعا می‌کند که عوامل هوش مصنوعی آن قادر به مدیریت تمام مراحل توسعه نرم‌افزار هستند، از جمله برنامه‌ریزی، کدنویسی، رفع اشکال و استقرار.

    جاه‌طلبی برای ۱۰ برابر کردن بهره‌وری مهندسان

    جاه‌طلبی اعلام شده وو، افزایش ۱۰ برابری بهره‌وری مهندسان از طریق این عوامل هوش مصنوعی است. کوجنیشن همچنین بهترین مورد آزمایشی برای خود است. این شرکت اعلام کرده است که ۹۵ درصد از کد خود را توسط دوین یا ابزارهای مرتبط می‌نویسد.

    مشتریان بزرگ و پروژه‌های تحول‌آفرین

    کوجنیشن مشتریان سازمانی بزرگی از فهرست Fortune 500 دارد، از جمله مرسدس بنز (Mercedes-Benz) و گلدمن ساکس (Goldman Sachs). نمونه مرسدس بنز بسیار چشمگیر است؛ گزارش شده است که دوین یک پروژه هشت ماهه نوسازی برای این خودروساز را به هشت روز کاهش داده است.

    ریشه‌های رقابتی و آینده مهندسی نرم‌افزار

    کوجنیشن در اواخر سال ۲۰۲۳ توسط اسکات وو و دو هم‌بنیانگذار دیگر تأسیس شد. هر سه از دنیای برنامه‌نویسی رقابتی می‌آیند و سابقه درخشانی در المپیاد جهانی انفورماتیک دارند.

    برای خود مهندسان، تصویر پیچیده‌تر است. وو مأموریت شرکت را توانمندسازی توسعه‌دهندگان برای افزایش بهره‌وری و گسترش حجم نرم‌افزار ساخته شده تعریف می‌کند، نه کوچک کردن این حرفه. خوانش خوش‌بینانه این است که تقاضا برای نرم‌افزار عملاً نامحدود است و توسعه ارزان‌تر به معنای پروژه‌های بیشتر، نه افراد کمتر خواهد بود. اما خوانش بدبینانه این است که شرکت‌ها ممکن است با استفاده از تیم‌های کوچک‌تر، سود حاصل از افزایش بهره‌وری را به جیب بزنند.

  • اپل درخواست‌های هوش مصنوعی برای داده‌های مک را پس از شکایات متا پرچم‌گذاری می‌کند

    اپل درخواست‌های هوش مصنوعی برای داده‌های مک را پس از شکایات متا پرچم‌گذاری می‌کند

    اپل در حال تشدید یکی از قدرتمندترین مجوزهای مک است. این شرکت اعلام کرده است که درخواست‌های هوش مصنوعی برای دسترسی به داده‌های مک، با کنترل‌های جدید و هشدارهای صریح در مورد تنظیماتی به نام “دسترسی کامل به دیسک” (Full Disk Access)، برای کاربران شفاف‌تر خواهد شد.

    زمان‌بندی حساس

    این اقدام در زمانی صورت می‌گیرد که شکایاتی مبنی بر دسترسی غیرمجاز عامل هوش مصنوعی Muse شرکت متا به محتوای پیام‌های خصوصی بدون مجوزهای لازم مطرح شده است.

    اپل به‌روزرسانی‌های سیستم‌عامل macOS را در تاریخ ۲ اکتبر ۲۰۲۶ اعلام کرد. تغییر اصلی بر روی “دسترسی کامل به دیسک” متمرکز است؛ مجوزی که به برنامه‌ها اجازه می‌دهد تا به عمق داده‌های ذخیره‌شده کاربر دسترسی پیدا کنند.

    اپل اعلام کرده است که اعطای این مجوز اکنون نیازمند “اقدام بسیار صریح کاربر” خواهد بود. هدف اعلام‌شده، جلوگیری از سوءاستفاده توسعه‌دهندگان از این سطح دسترسی است.

    این شرکت به‌روزرسانی را پاسخی به ریسک‌های در حال تغییر توصیف کرده است. اپل استدلال می‌کند که با افزایش قابلیت‌های ابزارهای هوش مصنوعی خودکار، خطرات مرتبط با دسترسی گسترده به داده‌ها نیز همگام با آن‌ها تکامل می‌یابد.

    عامل هوش مصنوعی Muse شرکت متا در اواسط سپتامبر ۲۰۲۶ یک برنامه مک دریافت کرد و مدت کوتاهی پس از آن، شکایاتی در مورد دسترسی آن به داده‌ها مطرح شد. برجسته‌ترین این شکایات از سوی جیسون آتن، ستون‌نویس فناوری، مطرح شد که اشاره کرد Muse به پیام‌های خصوصی او دسترسی یافته، حتی با وجود اینکه “دسترسی کامل به دیسک” فعال نشده بود.

    متا این ادعا را رد کرده است. این شرکت اعلام کرد که دسترسی صحیح به داده‌های Messages نیازمند مجوز صریح کاربر از طریق دو لایه است: “دسترسی کامل به دیسک” به همراه کانکتورهای اضافی که هر دو قابل لغو هستند.

    این رویداد، شکاف دیرینه در اکوسیستم اپل را برجسته می‌کند. در iOS و iPadOS، برنامه‌ها تحت قوانین سخت‌گیرانه‌تر “سندباکسینگ” (sandboxing) عمل می‌کنند که آن‌ها را از داده‌های یکدیگر جدا نگه می‌دارد. در مقابل، macOS از نظر طراحی همیشه انعطاف‌پذیرتر بوده است. “دسترسی کامل به دیسک” به این دلیل وجود دارد که نرم‌افزارهای حرفه‌ای و کاربران پیشرفته اغلب برای انجام وظایف خود به دسترسی گسترده نیاز دارند.

    به نظر می‌رسد راه‌حل اپل، سندباکس آیفون را به طور کامل به مک منتقل نمی‌کند. در عوض، اصطکاک و شفافیت را در لحظه‌ای که کاربر کلیدها را واگذار می‌کند، افزایش می‌دهد.

    سرمایه‌گذاران از این اعلامیه استقبال کردند. سهام اپل در روز انتشار این خبر حدود ۲ درصد افزایش یافت. سهام متا نیز حدود ۰.۳ درصد رشد کرد.

    برای اپل، این به‌روزرسانی بر برندی که به شدت بر حریم خصوصی بنا شده است، تأکید می‌کند. همچنین به طور نامحسوسی اپل را به عنوان دروازه‌بان عامل‌های هوش مصنوعی در پلتفرم خود معرفی می‌کند. هر شرکتی که بخواهد عامل هوش مصنوعی آن به طور عمیق در مک عمل کند، اکنون باید از طریق یک فرآیند مجوزدهی دقیق‌تر، کاربران را متقاعد کند.

    به طور خاص برای متا، راه‌اندازی Muse در مک با شروعی پر دست‌انداز همراه بود. این شرکت همچنان اصرار دارد که مدل مجوزدهی آن نیازمند رضایت کاربر در لایه‌های متعدد بوده است، اما روایت عمومی بیشتر بر ادعای آتن متمرکز شده است تا رد ادعای متا.

  • بنیاد اتریوم و OA از zkAPI برای پرداخت هوش مصنوعی خصوصی رونمایی کردند

    بنیاد اتریوم و OA از zkAPI برای پرداخت هوش مصنوعی خصوصی رونمایی کردند

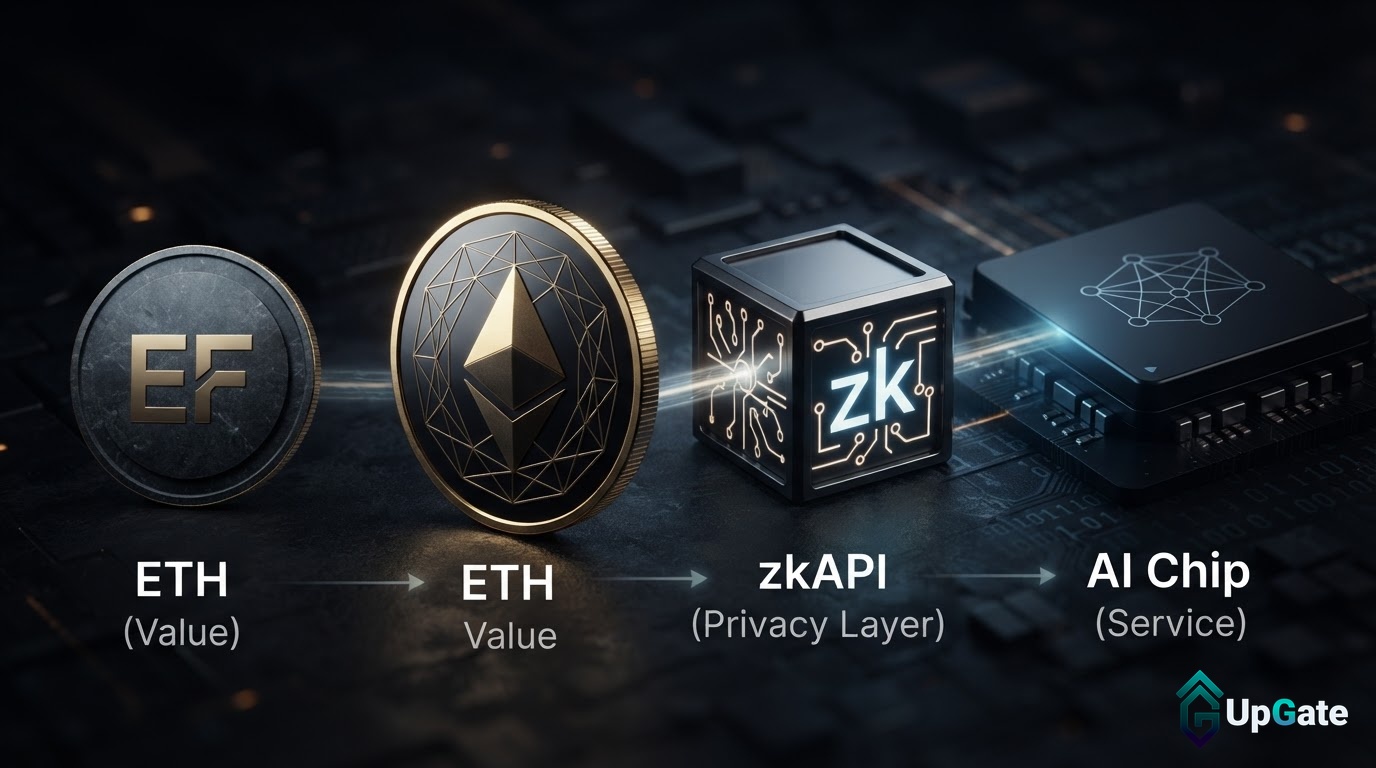
    بنیاد اتریوم و پروژه Open Anonymity پروتکل zkAPI را توسعه داده‌اند؛ پروتکلی مبتنی بر دانش صفر که به کاربران امکان می‌دهد برای خدمات هوش مصنوعی و سایر APIهای پولی هزینه پرداخت کنند، بدون اینکه هویت خود را به درخواست‌هایشان پیوند دهند.

    این سیستم که هم‌اکنون بر روی شبکه اصلی اتریوم (mainnet) فعال است، سوابق پرداخت را از درخواست‌ها و پرس‌وجوهای ارسال شده به ارائه‌دهندگان خدمات جدا می‌کند، هرچند که تمام فعالیت‌های شبکه یا محتوای ارسالی کاربران را پنهان نمی‌کند.

    پروژه Open Anonymity در پستی در تاریخ ۲۵ سپتامبر ۲۰۲۶، همکاری خود با بنیاد اتریوم را اعلام کرد و خدمات چت عمومی هوش مصنوعی خود با نام OA-chat را معرفی نمود. بنیاد اتریوم نیز در تاریخ ۲ اکتبر، zkAPI را با توصیف «وسیله‌ای برای هوش مصنوعی خصوصی» معرفی کرد.

    این پروتکل در ابتدا توسط دیوید کراپیس، پژوهشگر اتریوم، و ویتالیک بوترین، هم‌بنیان‌گذار اتریوم، پیشنهاد شد و تیم Open Anonymity کلاینت، سرور، قراردادهای هوشمند و یکپارچه‌سازی مرورگر را ساخت.

    کاربران ابتدا مقداری ETH را به قرارداد ZkAPIVault در شبکه اصلی اتریوم واریز می‌کنند. این واریز سپس با استفاده از یک درخت مرکل (Merkle tree)، که یک ساختار داده رمزنگاری شده است، به یک تعهد (commitment) تبدیل می‌شود، در حالی که موجودی قابل خرج به صورت یک یادداشت خصوصی در دستگاه کاربر نگهداری می‌شود.

    در ابتدای هر جلسه، مرورگر یک اثبات دانش صفر (zero-knowledge proof) تولید می‌کند که ثابت می‌کند کاربر دارای وجوه کافی برای پرداخت است و هنوز آن پول را خرج نکرده است. تأیید پرداخت بدون اطلاع از سپرده خاص مورد استفاده برای پرداخت و هویت کاربر انجام می‌شود.

    پس از تکمیل تأیید، یک کلید API با سقف هزینه صادر می‌شود و درخواست مستقیماً از مرورگر به ارائه‌دهنده هوش مصنوعی ارسال می‌گردد. پس از انقضای کلید API، رسید استفاده دریافت خواهید کرد. سپس سیستم آن مبلغ را از موجودی خصوصی کسر می‌کند و یک شماره سریال یک‌طرفه به نام nullifier از خرج شدن مجدد همان وجوه جلوگیری می‌کند.

    این پروتکل از اثبات‌های Groth16، رمزنگاری BN254 و هشینگ Poseidon برای خصوصی و قابل تأیید بودن سیستم پرداخت استفاده می‌کند و کاربران می‌توانند وجوه باقی‌مانده خود را مستقیماً از طریق قرارداد vault برداشت کنند، حتی اگر سرورهای zkAPI از کار بیفتند.

    این پروتکل پیوند پرداخت را پنهان می‌کند، نه محتوا را. ارائه‌دهنده همچنان درخواست‌ها و جزئیات شبکه مانند آدرس IP را مشاهده می‌کند و می‌تواند با زمان‌بندی، جلسات را مطابقت دهد. توسعه‌دهندگان استفاده از Tor با یک مدار (circuit) تازه برای هر جلسه را پیشنهاد می‌کنند، زیرا تاریخچه مکالمات تکراری، سبک نوشتاری یا جزئیات شخصی می‌تواند به ارائه‌دهنده اجازه دهد تا جلسات فردی را دوباره پیوند دهد.

    این پروژه به علایق اخیر بوترین نزدیک است. به یاد بیاورید که اواخر ماه گذشته او نقشه راه بلندمدت اتریوم را به اشتراک گذاشت که بر اثبات‌های رمزنگاری و تأیید تأکید بیشتری داشت. zkAPI این رویکرد کلی را برای پرداخت‌های روزمره به کار می‌برد و به یک سرویس اجازه می‌دهد تا بدون دریافت هویت حساب متعارف، هزینه را تأیید کند.

  • اتریوم: پرداخت هوش مصنوعی ناشناس ممکن شد

    اتریوم: پرداخت هوش مصنوعی ناشناس ممکن شد

    بنیاد اتریوم zkAPI را روی شبکه اصلی اتریوم راه‌اندازی کرد؛ سیستمی که به گفته این بنیاد، به افراد امکان می‌دهد برای خدمات هوش مصنوعی هزینه پرداخت کنند بدون آنکه هویتشان با پرسش‌هایشان گره بخورد.

    حریم خصوصی در هوش مصنوعی

    بنیاد اتریوم در این باره استدلال کرده است: «پرسش‌ها شخصی هستند. افراد درباره سلامت، امور مالی و تردیدهای خود از مدل‌های هوش مصنوعی می‌پرسند. در مدل فعلی، استفاده از هوش مصنوعی به معنای ارائه رونوشت کاملی از افکار شما به هر کسی است که رابطه صورتحساب را در دست دارد.»

    این بنیاد ادامه داد: «zkAPI پرداخت را از هویت جدا می‌کند. شما اعتبار (ETH، USDC و غیره) را در یک قرارداد خزانه در اتریوم، که یک تراکنش معمولی است، واریز می‌کنید. از آن پس، موجودی شما به عنوان یک یادداشت خصوصی وجود دارد: پول دیجیتالی که فقط شما می‌توانید خرج کنید و هیچ‌کس نمی‌تواند آن را به واریز اولیه ردیابی کند.»

    این سیستم با پروژه Open Anonymity (OA) ساخته شده است. همراه با راه‌اندازی zkAPI، OA Chat نیز معرفی شده است؛ یک چت‌بات خصوصی مبتنی بر مرورگر که نیازی به نصب ندارد و کد آن در GitHub به صورت متن‌باز منتشر شده است.

    نگرانی‌ها درباره حریم خصوصی در فضای هوش مصنوعی امری انتزاعی نیست. در ماه مه ۲۰۲۵، یک دادگاه فدرال در دعوای حقوقی مربوط به حق نشر که توسط نیویورک تایمز و سایر ناشران مطرح شد، دستور داد که OpenAI سوابق خروجی خود، از جمله چت‌هایی که کاربران حذف کرده بودند، را حفظ کند.

    نحوه عملکرد zkAPI

    با این پیاده‌سازی، هر بار که می‌خواهید از هوش مصنوعی سؤالی بپرسید، نرم‌افزاری روی دستگاه شما یک اثبات دانش صفر (zero-knowledge proof) ایجاد می‌کند؛ یک رسید ریاضی که یک واقعیت را بدون نمایش جزئیات پشت آن اثبات می‌کند. این اثبات نشان می‌دهد که شما بودجه کافی دارید و قبلاً آن را خرج نکرده‌اید.

    سرور این اثبات را بررسی کرده و یک کلید API موقت برمی‌گرداند که اساساً یک رمز عبور است و به نرم‌افزار اجازه می‌دهد با سرویس هوش مصنوعی ارتباط برقرار کند. این کلید به یک مبلغ دلاری محدود شده و فقط در حافظه دستگاه شما وجود دارد.

    سپس درخواست‌های شما با این کلید و هیچ اطلاعات دیگری به ارائه‌دهنده هوش مصنوعی ارسال می‌شود. نه نامی و نه جزئیات پرداختی.

    هنگامی که کلید منقضی می‌شود، ارائه‌دهنده یک رسید استفاده امضا شده صادر می‌کند و شما به اندازه آنچه واقعاً استفاده کرده‌اید، نه سقف تعیین شده، هزینه پرداخت می‌کنید. ارائه‌دهنده می‌بیند که شما چه پرسیده‌اید و لایه پرداخت می‌بیند که چقدر هزینه کرده‌اید، و هیچ‌کدام نمی‌توانند این دو را به هم مرتبط کنند.

    مستندات پروژه، کلیدهای کوتاه‌مدت را که با OpenRouter کار می‌کنند، شرح می‌دهد؛ سرویسی که از طریق یک اتصال به صدها مدل هوش مصنوعی دسترسی می‌دهد. هر برنامه‌ای که از فرمت OpenAI پشتیبانی کند، می‌تواند با اشاره به یک آدرس محلی، متصل شود.

    این ایده از پیشنهادی سرچشمه می‌گیرد که داویده کراپیس و ویتالیک بوترین در فوریه در Ethereum Research منتشر کردند. کراپیس رهبری تیم هوش مصنوعی بنیاد اتریوم را بر عهده دارد که هدف آن تبدیل اتریوم به لایه ترجیحی تسویه و هماهنگی برای هوش مصنوعی است.

    او قبلاً اتریوم را به عنوان زیرساخت برای عامل‌های نرم‌افزاری معرفی کرده بود. در اوت ۲۰۲۵، کراپیس و مارکو د روسی استاندارد ERC-8004 را پیشنهاد کردند؛ یک مجموعه قوانین مشترک که به عامل‌های هوش مصنوعی مستقل اجازه می‌دهد یکدیگر را پیدا کرده، هویت را تأیید و تراکنش انجام دهند. کراپیس پیش‌بینی کرده بود که بیشتر ترافیک اتریوم ظرف سه تا پنج سال آینده از سوی ماشین‌ها خواهد بود.

    بوترین نیز همین مسیر را دنبال کرده است. در ۱۰ فوریه، او نقشه‌ای راه اتریوم و هوش مصنوعی را ترسیم کرده بود که شامل پرداخت‌های دانش صفر برای استفاده خصوصی از API می‌شد.

    در آوریل، او مسیر دیگری را نشان داد: اجرای یک مدل متن‌باز به صورت محلی روی کارت گرافیک Nvidia 5090 خود، به جای ارسال اطلاعات زندگی خود به سرویس‌های ابری. مدل‌های محلی داده‌های شما را در خانه نگه می‌دارند. zkAPI موردی را پوشش می‌دهد که در آن پرسش‌های شما همچنان به سرورهای شخص دیگری ارسال می‌شوند.

    بر اساس این پست، همین زیرساخت می‌تواند سایر خدمات مبتنی بر مصرف را نیز پوشش دهد: پرس‌وجوهای داده بلاک‌چین، تولید تصویر و ویدئو، VPNها و پرداخت بین ماشین‌ها. ارائه‌دهندگان برای ادغام مستقیم، باید به جای کلید API، یک اثبات را بپذیرند و رسیدهای استفاده امضا شده را تسویه کنند.

    مخزن کد این پروتکل را آزمایشی توصیف کرده و حسابرسی رسمی را ذکر نکرده است.